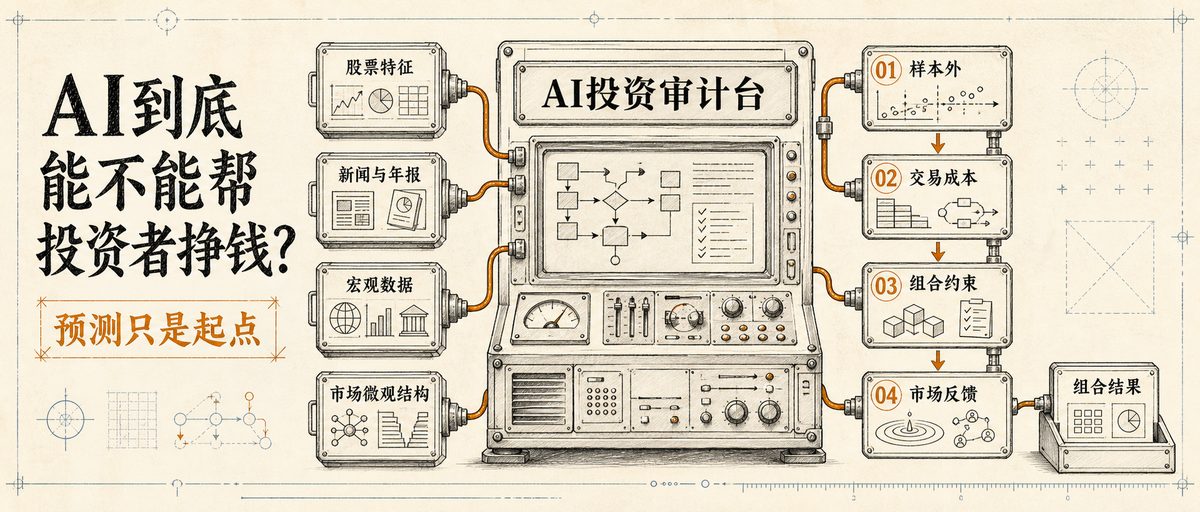
很多人对AI+金融的好奇,其实没有那么复杂,最后往往就是一句话:这东西到底能不能帮我挣钱?
如果只看标题,答案似乎很简单:机器学习可以预测收益率,大模型可以读新闻,智能体可以自动交易,金融机构会全面AI化。
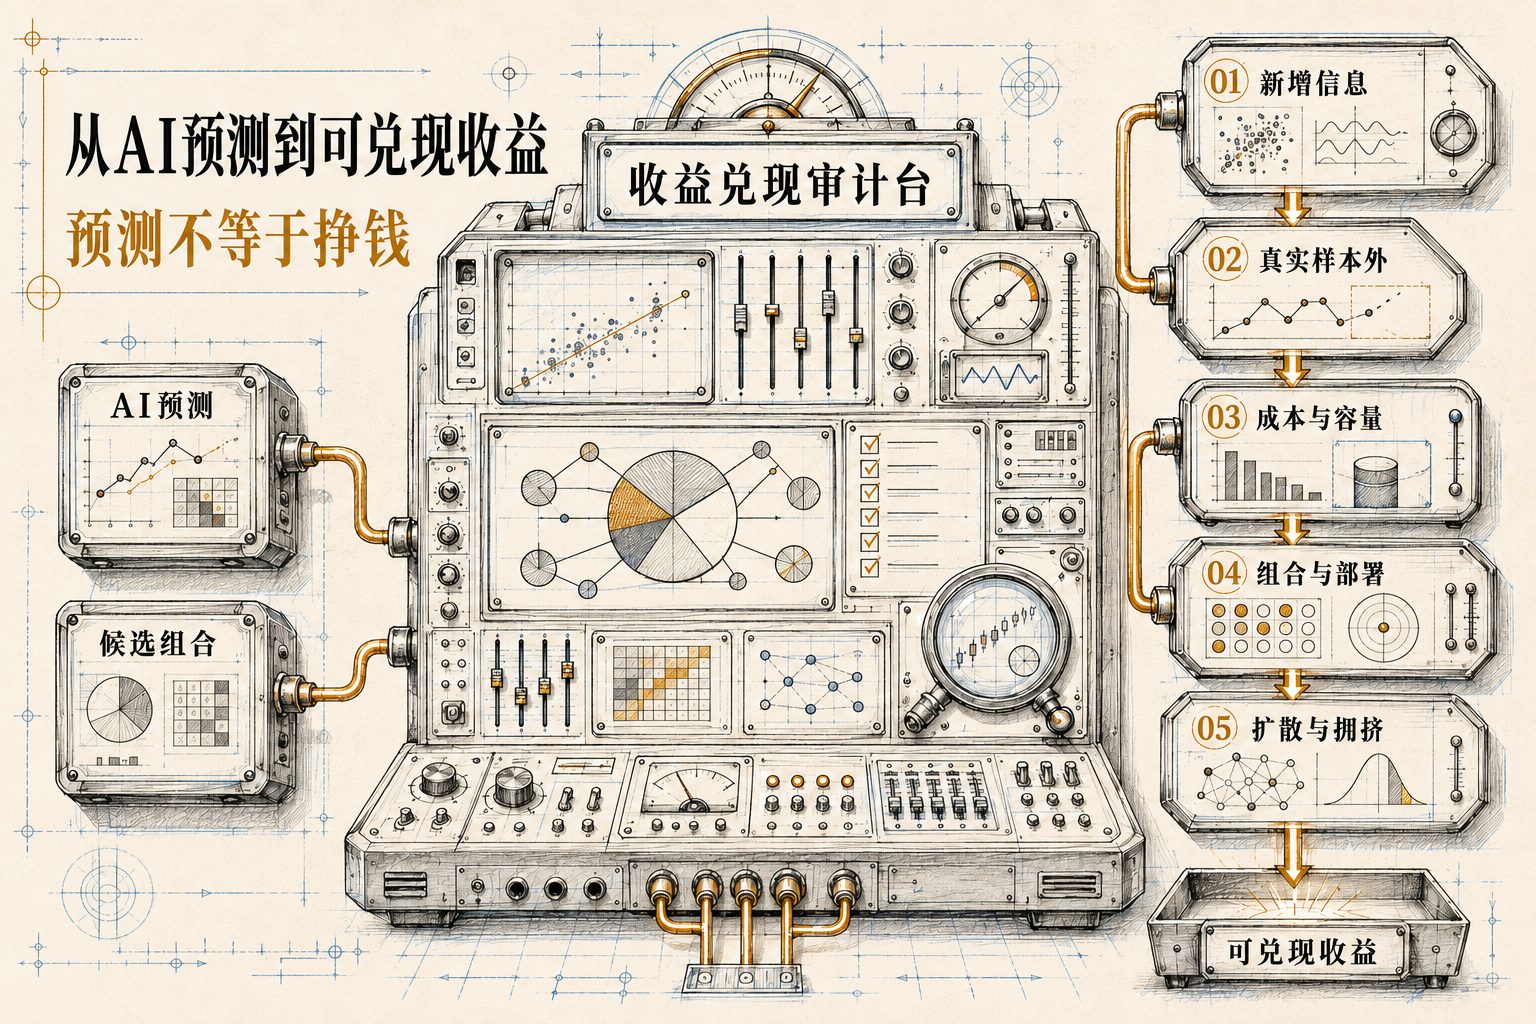
但“能预测”不等于“能挣钱”,“回测能挣钱”也不等于现实中能挣到钱。真正读进文献之后,问题会迅速变复杂:模型发现的是新信息,还是事后筛选出来的规律?样本外有效,是否意味着没有前视偏差?论文里的高夏普比率,扣除换手、冲击和容量后还能剩多少?海外市场有效的模型,为什么到了A股可能失效?当越来越多人使用相似模型时,优势会消失,还是会形成新的拥挤和系统风险?
所以,本文真正要回答的,不是“AI能不能预测股价”,而是一个更严格的问题:AI产生的预测,能否经过数据、样本外、交易成本、组合约束和市场反馈的层层检验,最终转化成投资者可以兑现的收益?
声明: 本文梳理学术与机构研究证据,讨论方法边界与可实施性,不构成任何投资建议,也不构成对具体证券、基金或策略的推荐。
研究工作流|这篇文章是怎样用 AI 完成的
以下说明提问、双路检索、文献入库与分级阅读的方法细节。若只关心投资相关结论,可跳过本段。
为回答上述问题,我搭建了一套人机协作的文献研究流程。起初只确定了二级市场投资者这一观察视角,并未预设完整问题清单。Codex 先从文献中提出候选问题,再通过浏览器调用 Grok 订阅补充投资者可能关心的角度,并做反方检索。需要强调:Grok 用于拓展问题与寻找反例,最终证据仍以论文全文、摘要和权威机构报告为准。
问题形成后,Codex 继续检索文献,并通过本地 Zotero CLI 桥接完成查重、补录、分类与标签管理。公开可获取的 PDF 由系统自动挂接;受出版社限制的全文则列出 DOI,再由人工补齐。阅读并不平均用力:能够搭建研究框架、提供核心实证或改变制度判断的文献优先核读全文;重复比较分类器、缺少样本外检验或经济价值有限的研究,通常只核对摘要和结果表。最后将证据整理成矩阵,复核数据、样本、时间切分、交易成本与结论边界。
这篇文章不追求把AI金融的所有分支都讲一遍,只围绕二级市场投资者最关心的十二个问题,给出目前证据允许的答案。
前六问先完成第一轮筛选:AI提供了什么信息,预测能否在样本外成立,扣除成本后能否赚钱,机构能否部署,优势能否持续,以及它会不会制造新的系统风险。后六问再像一次策略尽调,继续检查模型冲突、状态失效、数据泄漏、跨市场迁移、仓位转化和策略拥挤。
- AI到底带来了什么新增信息?
- 这些信息能否在样本外成立?
- 扣除交易成本、换手率和容量后,还有没有经济价值?
- 金融机构有没有真实部署条件?
- 通用模型扩散后,优势还能剩多少?
- AI会不会带来新的系统性风险?
- 多个AI模型给出冲突信号时,应该相信谁?
- 模型在什么市场状态下会失效?
- 回测结果是真的,还是被数据泄漏制造出来的?
- 海外有效的AI策略,为什么到了A股可能失效?
- 怎样把AI预测转化为组合和仓位?
- AI普及后,如何识别策略同质化和拥挤?
一、AI到底带来了什么新增信息?
AI没有凭空创造一种新的金融规律。它真正扩大的,是投资者能够系统处理的信息边界。
传统量化研究擅长处理价格、成交量、估值、盈利和宏观变量,但当变量变成几百、几千个以后,线性模型很容易遇到共线性、变量筛选和非线性交互问题。Gu、Kelly和Xiu(2020)发表在《Review of Financial Studies》的研究表明,树模型和神经网络能够从大量股票特征中提取比线性模型更强的样本外预测信号。
但这篇论文也给AI祛了魅:重要特征仍主要来自动量、流动性、波动率和估值等熟悉类别。至少在这项研究中,机器的优势不是发现了人类从未见过的神秘因子,而是更擅长处理变量之间复杂、非线性且随时间变化的关系。
更大的变化来自文本。
过去,投资者当然知道新闻、年报和电话会重要,但很难持续阅读全市场数千家公司、数百万份文件。大模型和自然语言处理把这些原本难以规模化的信息,变成了可以计算、比较和回测的变量。
例如,《Bottom Up vs. Top Down: What Does Firm 10-K Tell Us?》不是拿现成的情绪词典给年报打分,而是从10-K文本中重新学习与未来收益相关的词组。结果显示,文本信息在小公司、分析师覆盖少、投资者关注低和买卖价差宽的公司中更有价值(Ross et al., 2026)。
这很符合投资直觉:信息优势最可能出现在“公开但尚未被充分处理”的地方,而不是所有人都盯着的热门公司。
新闻研究则把文本信息推进到了资产定价层面。《News and Asset Pricing: A High-Frequency Anatomy of the SDF》把实时新闻与高频随机贴现因子跳跃联系起来,说明新闻文本不只是简单的利好利空标签,还可能反映系统性风险和风险溢价(Aleti et al., 2025)。
所以,AI带来的新增信息主要有两类:一类是高维结构化变量中的非线性交互;另一类是新闻、年报、公告、电话会和其他非结构化材料中,过去无法低成本批量提取的信息。
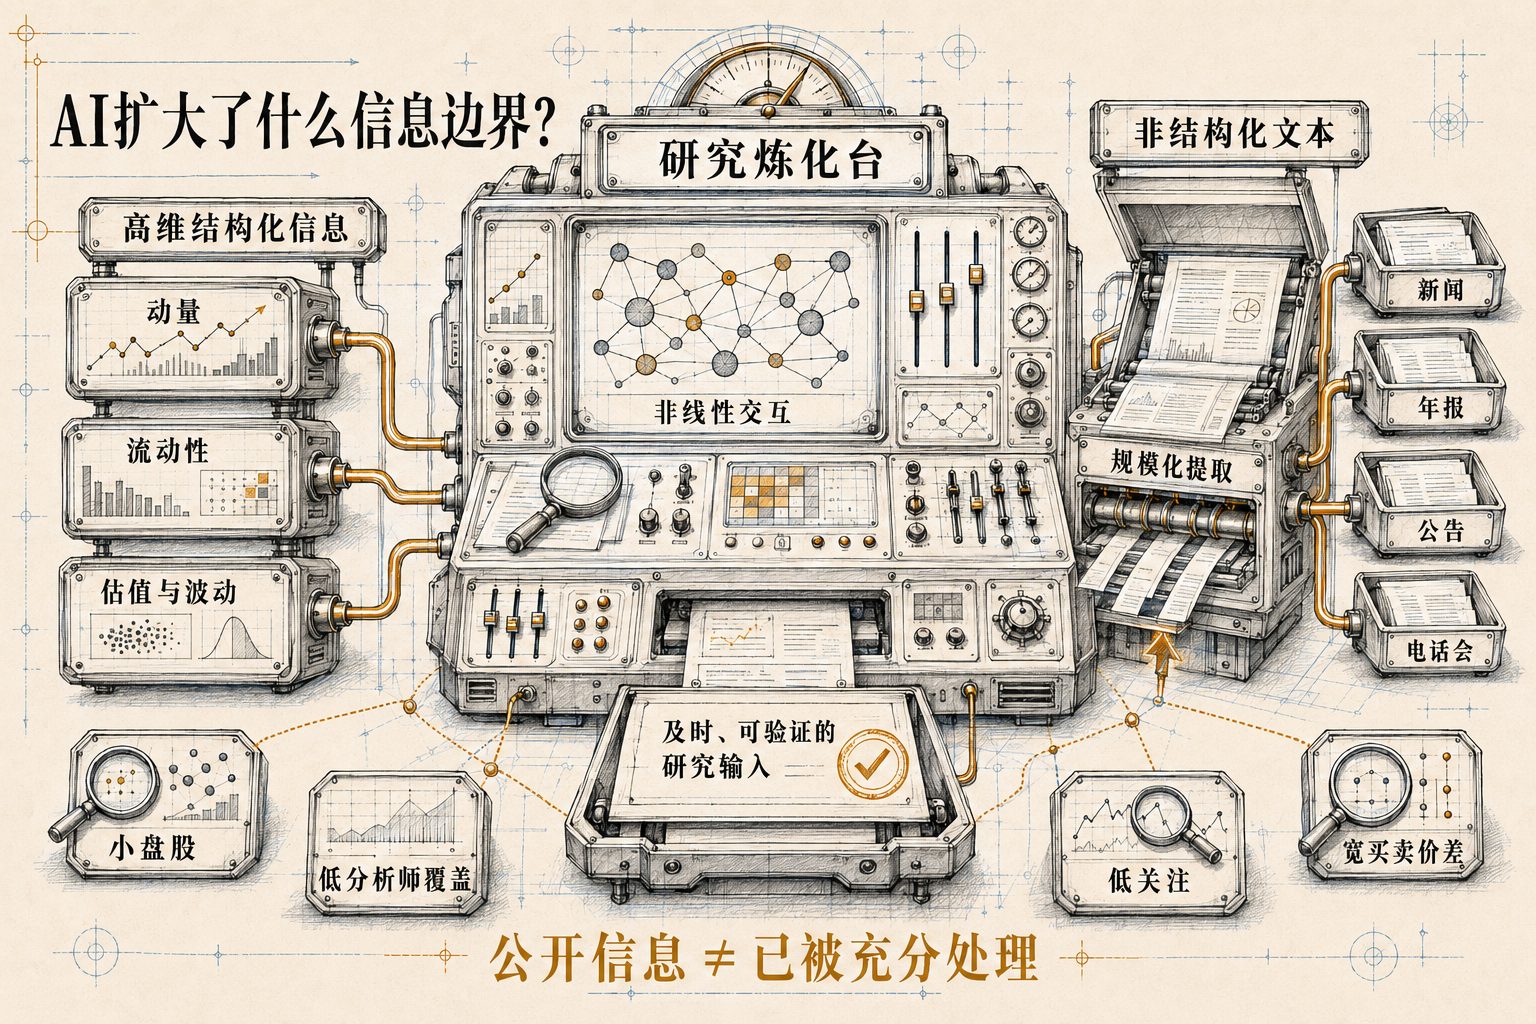
对投资者而言,真正值得问的不是“模型是不是AI”,而是:它有没有把以前处理不了的信息,变成新的、及时的、可验证的研究输入?
二、这些信息能否在样本外成立?
部分成立,但“样本外”三个字本身不构成质量保证。
最容易制造“虚假样本外”的做法,是把全部数据随机分成训练集和测试集。金融数据有明确的时间顺序,随机切分可能让模型间接看到未来市场状态。真正可信的设计,应当让模型像历史上的投资者一样,只能使用预测时点之前的信息。
Gu、Kelly和Xiu(2020)使用长样本,并保留约30年的测试期。10-K研究用1995—2007年估计模型,在2008—2022年形成样本外预测,还把文件与收益数据错开,避免使用尚未公开的年报(Ross et al., 2026)。
中国市场的证据也说明,样本外有效并不等于不同市场共享同一套规律。Leippold、Wang和Zhou(2022)在《Journal of Financial Economics》的研究使用90个股票特征、11个宏观变量和行业变量形成1,160个预测信号,严格区分训练、验证和测试阶段。机器学习在中国股票市场确实取得了正的样本外预测能力,但最重要的变量集中在流动性、异常换手和本地趋势;美国研究中领先的某些特征,到了中国并不领先。
这说明样本外问题至少有三层:
第一,模型有没有离开训练样本;第二,预测时是否只使用当时可获得的信息;第三,结论换到另一个时期、市场和制度环境后是否仍然成立。
真正值得信的论文,还应当和简单基准比较。复杂模型如果不能稳定超过历史均值、线性模型、简单排序或等权组合,就不能仅凭“用了深度学习”获得额外可信度。
所以,AI预测在样本外并非完全失效,但它是有条件的:时间切分必须严格,信息时点必须真实,模型必须与简单方法比较,而且最好能够转化成样本外组合,而不仅是报告分类准确率。至于数据和模型是否真的只包含当时信息,第九问还会做一次更严格的审计。
三、扣除交易成本、换手率和容量后,还有没有经济价值?
有些策略仍有经济价值,但这是论文结果转化为真实收益时最残酷的一道筛选。
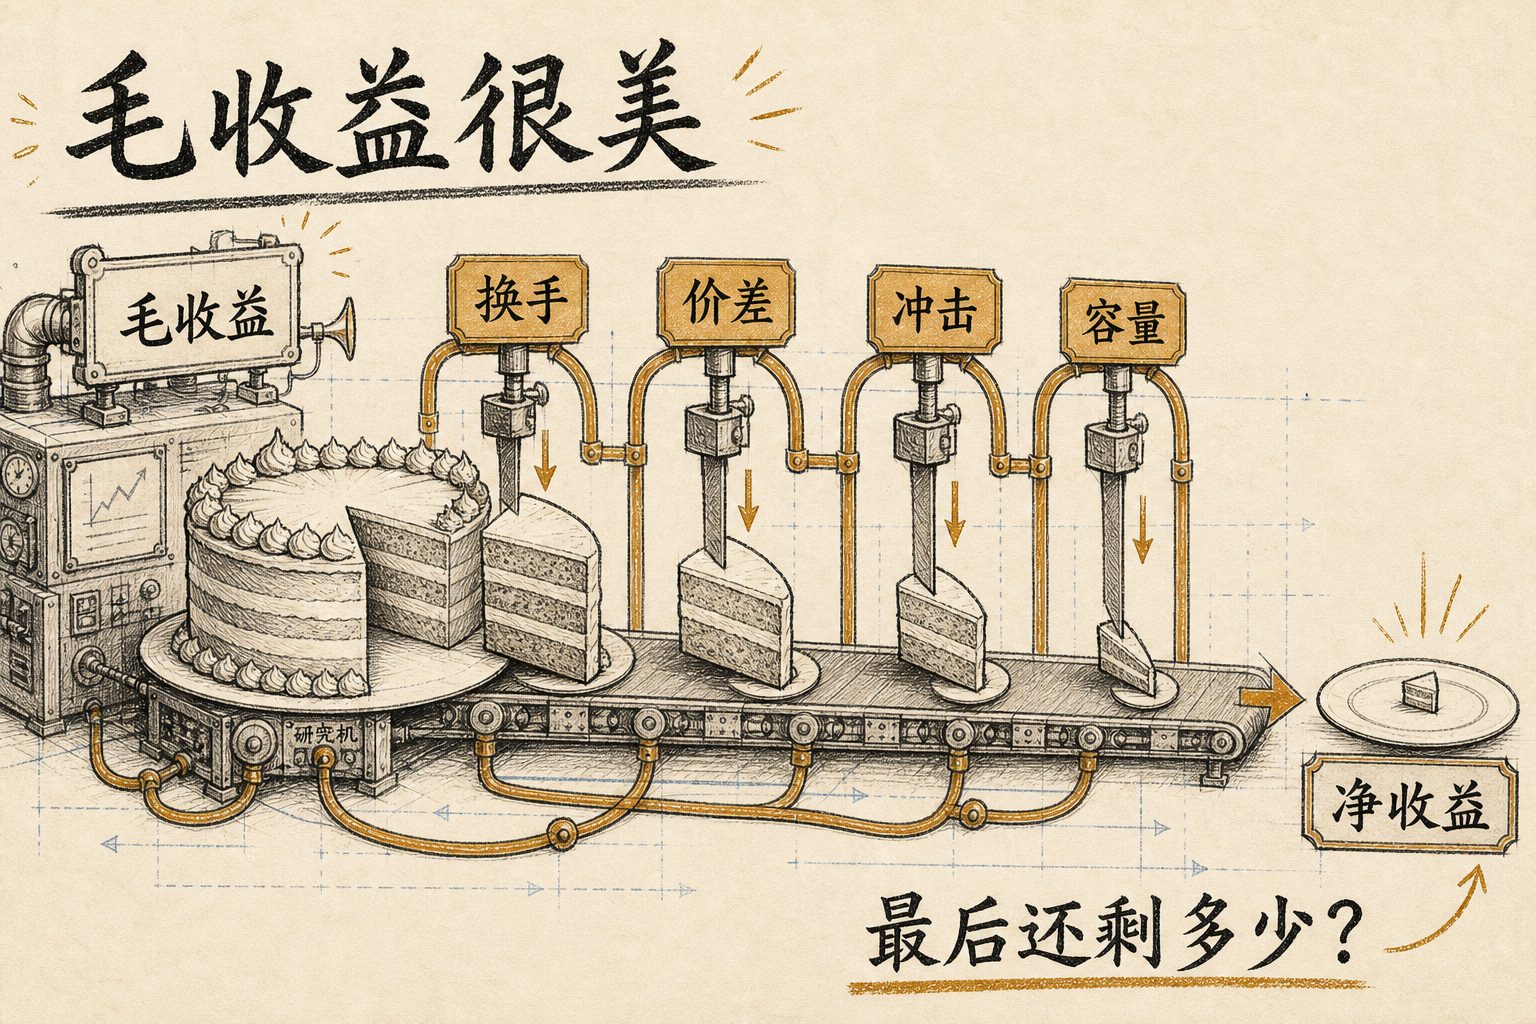
预测正确不等于可以赚钱。一个信号可能主要出现在小盘股,可能要求每天调仓,也可能需要卖空借券困难的股票。论文里的毛收益,在真实市场中要依次经过买卖价差、佣金、冲击成本、借券成本、滑点和容量约束。
ChatGPT新闻预测研究很好地说明了这个问题。GPT能够从新闻标题中提取与短期价格漂移相关的信息,但部分策略需要接近每天重建组合,高换手会迅速吞噬收益。更麻烦的是,预测力较强的区域往往又集中在小盘、低关注和负面新闻公司,而这些股票通常交易成本更高、容量更小(Lopez-Lira & Tang, 2023)。
Jensen、Kelly、Malamud和Pedersen(2026)的《Machine Learning and the Implementable Efficient Frontier》更进一步:它没有在模型预测完以后简单减去一个固定成本,而是把交易成本、市场冲击、风险和资金规模直接放进模型目标。
结果很重要。忽视成本时看起来漂亮的排序策略和Markowitz式机器学习组合,净表现可能很差;直接针对可实施目标学习权重的Portfolio-ML,在更大的资金规模下仍能保留较好的成本后表现。但同一个模型在管理10亿美元与100亿美元时,最优持仓、调仓速度和有效前沿都不一样。
这意味着交易成本不是回测末尾的一行扣减,而是会反过来改变:
- 哪些信号值得使用;
- 模型应该多快更新;
- 权重应该多集中;
- 短期反转等高换手信号还有没有价值;
- 一项策略最多能容纳多少资金。
Li等人(2025)关于18,113个实时基本面信号的研究也提供了一个有用校准。它的机器学习策略表现不如使用事后精选特征的研究耀眼,但基本面信号更新较慢,月度双边换手率约为14%;估算交易成本后,等权和价值加权组合仍保留正的净收益。
所以,投资者不能只问论文的夏普率是多少,还要继续问:这是毛收益还是净收益?换手怎么算?是否计入市场冲击和借券成本?收益是否主要来自微盘股?资金扩大十倍以后,策略还剩多少?
前三问完成了从预测信号到可实施收益的第一轮筛选。接下来还要看,它能否进入真实机构的研究、交易和风控流程。
四、金融机构有没有真实部署条件?
有,但最先落地的通常不是“让AI独立管理资金”,而是内部效率、信息处理、代码、合规和风控。
这看似离个人投资者较远,却直接决定论文中的策略能否被现实资金采用,也决定一项优势会以多快的速度被竞争者消化。
金融稳定理事会(Financial Stability Board,2024;以下简称FSB)对金融机构的调研显示,AI应用正在加速,但成熟用例仍主要集中在内部运营和监管合规。生成式AI常见于文档摘要、知识检索、代码生成、客户服务和员工辅助。能够直接影响授信、定价、交易和风险限额的高重要性决策,推进得更谨慎。
原因并不神秘。金融模型投产需要解决的不只是准确率,还包括数据权限、隐私、公平、解释、责任归属、模型更新、第三方依赖和极端状态下的人工接管。
BIS的Project Aurora就是一个典型案例。传统反洗钱系统会产生大量误报,机器学习、网络分析、隐私增强技术和跨机构协作有机会显著改善识别能力。但概念验证成功并不等于可以直接部署。真实运行还需要统一数据标准、法律授权、跨境协调以及公共部门和私营机构之间的治理安排(BIS Innovation Hub Nordic Centre, 2023)。
Aurora虽然不是二级市场投研案例,但它揭示了金融AI投产普遍绕不开的约束:数据标准、法律权限、跨机构协作和责任治理。
资管行业的实证更接近投资者。《Generative AI and Asset Management》发现,生成式AI采用与部分对冲基金更好的后续表现相关,但收益并没有平均分配。更大、更老、更活跃、拥有AI人才的基金受益更明显;小基金和缺少互补能力的机构没有同样结果(Sheng et al., 2026)。
这提醒我们:购买模型接口只是部署中最容易的一环。真正的能力还包括专有数据、研究流程、低成本执行、风控体系、人才和组织协调。
所以,判断一家金融机构是否真正受益于AI,不能只看它是否宣布接入大模型,而要看AI是否进入了可重复的业务流程,能否降低单位成本、缩短处理时间、减少错误,同时没有显著增加合规和模型风险。
五、通用模型扩散后,优势还能剩多少?
公开信息处理上的表层优势更容易衰减;由数据、流程和执行构成的深层优势更可能保留,甚至扩大。
如果大模型能够比边际投资者更快理解一条新闻,那么在使用尚未普及时,价格可能出现短暂漂移。但当越来越多机构调用相似模型、读取相同新闻时,信息会更快进入价格,原来的优势自然缩小。
因此,建立在公开新闻和通用提示词上的超额收益(alpha),很可能具有明显的过渡期特征。模型能力越便宜、越标准化,这部分优势越难长期独占。
但“人人都能用模型”不等于“人人获得相同结果”。
《Valuing Financial Data》表明,同一份数据对不同投资者的价值并不相同。投资者已有数据、交易范围、资金规模、价格冲击和市场流动性,都会影响新增数据的边际价值(Farboodi et al., 2025)。生成式AI资管研究也显示,真正受益的是能够把模型与人才、数据和执行结合起来的机构(Sheng et al., 2026)。
未来更难复制的优势,可能来自五个方面:
- 别人没有或难以及时获得的数据;
- 能够把文本、基本面和交易数据连接起来的研究流程;
- 更低的执行成本和更好的容量管理;
- 对模型失效、幻觉和极端情景的治理能力;
- 能把AI嵌入组织,而不是停留在个人工具层面的人才结构。
所以,AI并不一定拉平机构差距。它可能先把通用信息处理能力变成商品,再把竞争焦点推向更昂贵、更难模仿的互补资产。
六、AI会不会带来新的系统性风险?
会。风险不只来自单个模型判断错误,还来自许多模型同时做出相似反应。
FSB(2024)把相关风险归纳为第三方服务集中、共同模型和共同数据导致的行为相关性、网络攻击、数据质量、模型幻觉以及治理不足。如果许多机构依赖少数云平台、基础模型和数据供应商,一个局部故障或模型更新就可能同时影响大量金融活动。
市场层面的风险更值得二级投资者关注。
Dou、Goldstein和Ji(2025)研究AI交易算法时发现,彼此独立、没有直接通信、也没有预先设定合谋目标的学习算法,仍可能通过价格互动减少激进的信息交易,形成高于竞争状态的利润,并损害流动性和价格效率。这是理论和模拟证据,不能直接写成现实市场已经发生大规模AI合谋,但它证明了非预期集体行为在机制上是可能的。
强化学习做市研究也发现,算法不需要交换消息,仅通过共同观察市场价格并不断适应,就可能形成高于竞争均衡水平的买卖价差(Cont & Xiong, 2024)。
压力期问题更加明显。如果多个机构使用相似风险指标和自动退出规则,波动上升可能同时触发减仓、撤出流动性和降低杠杆。这些动作对单个机构可能是理性的,叠加后却会放大市场冲击。
因此,未来监管和投资者不能只问“这个模型准不准”,还要问:谁在使用相似模型?依赖哪些共同服务商?压力期是否会同时退出?多个智能体放在同一个市场中,会形成怎样的反馈循环?
到这里,前六问给出了第一轮答案:AI可能创造可用信号,但从信号到收益之间隔着实施条件、竞争扩散和系统反馈。下面六问进一步进入策略内部,检查模型在真实使用中会在哪里出错。
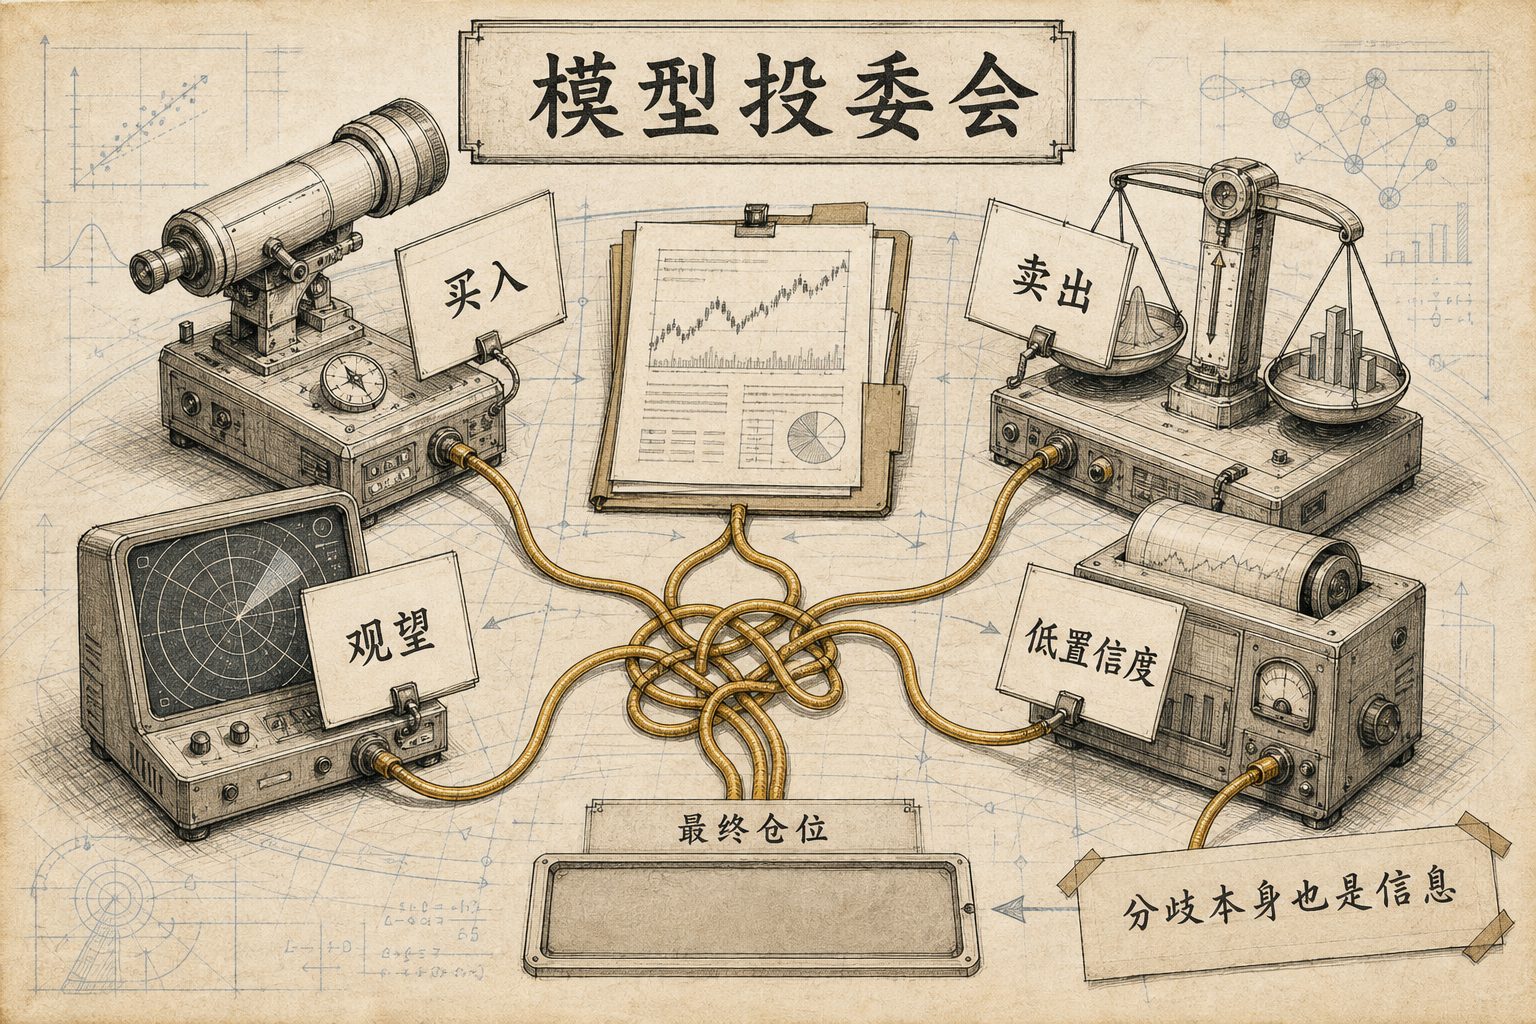
七、多个AI模型给出冲突信号时,应该相信谁?
不要急着选出一个“最聪明的模型”。先判断分歧来自哪里,再决定是平均、降权,还是把分歧本身当作信号。
模型冲突至少有三种。
第一种是同一模型因随机初始化、抽样和训练噪声产生的小幅差异。这类分歧通常可以通过多次训练取平均来降低。Gu、Kelly和Xiu(2020)训练神经网络时就使用多个随机种子平均预测,以减少单次优化的不稳定性。
第二种是不同模型结构之间的分歧。线性模型、树模型和神经网络可能分别捕捉不同关系。此时,验证期表现和滚动样本外结果比模型复杂度更重要。历史上最强的模型,不一定在下一个市场状态中继续领先。
第三种更有意思:模型分歧可能反映真实的经济不确定性。
Bali等人(2026)在《Machine Forecast Disagreement》中,用多个机器学习模型对同一股票的预测离散度构造MFD指标。样本外结果显示,低分歧股票的后续收益显著高于高分歧股票。进一步分析发现,高分歧股票的低收益主要集中在借券昂贵、散户持股较高的公司。
这意味着分歧不只是“模型没训练好”。当乐观预测难以被卖空力量纠正时,高分歧可能对应被高估的股票。
另一篇《Ambiguity with Machine Learning》给出了从分歧到仓位的直接方法。作者不强迫投资者从多个预测模型中挑一个赢家,而是估计由模型、变量、参数和函数形式变化产生的预期收益歧义,再把它作为独立于风险协方差的惩罚项放入组合优化。歧义越大,相关资产的仓位越受抑制(Ghysels et al., 2021)。
这里有一个重要区别:风险是“我们大致知道分布,只是不知道下一次结果”;歧义则是“我们连该相信哪个预期收益模型都不确定”。两者不能只用一个波动率指标代替。
所以,面对冲突信号时,合理顺序是:先排除训练噪声,再比较滚动样本外稳定性,然后判断分歧是否具有经济含义,最后才决定平均预测、降低仓位或暂停模型。不能机械地认为多数投票一定正确,也不能把所有分歧按同一比例减仓。
八、模型在什么市场状态下会失效?
模型最危险的时候,不是正常时期误差稍微变大,而是数据生成机制已经改变,模型却仍给出精确答案。
金融关系会随着危机、政策、监管、投资者结构和交易制度而变化。疫情一类分布外冲击尤其容易暴露历史关系的脆弱性。Buckmann、Haldane和Hüser(2021)指出,机器可以从历史数据中识别常见脆弱性,却很难理解从未出现过的制度和行为变化;极端不确定性下,精确输出反而可能制造虚假信心。
Wang和Lera(2026)的FinPFN尝试解决关系漂移。它不要求研究者提前把市场标成牛市、熊市或危机,而是根据最近一段时间的“特征—收益”关系即时调整。模型同时在中国股票日频数据和美国股票月频数据上检验,在市场状态发生明显切换的附近,适应能力更有价值。
但这项研究也提醒我们,不要把漂亮结果直接当成可实施收益。中国市场组合的高夏普比率没有完整扣除交易成本;而且同一模型在中美市场使用的频率和样本不同,不能简单比较哪个市场更适合AI。
现实中的失效监控,至少应观察四类信号:
- 预测误差是否持续超出历史范围;
- 特征重要性和模型间相关性是否突然改变;
- 换手、冲击成本和成交失败是否同步上升;
- 策略收益是否集中暴露于某个未预期的行业、风格或宏观状态。
问题在于,目前高质量金融文献还没有给出一个能够跨资产、跨频率通用的停用阈值。因此,文章可以明确提出漂移监控和人工接管的重要性,却不能声称“波动率达到某个数值就应关闭所有AI策略”。
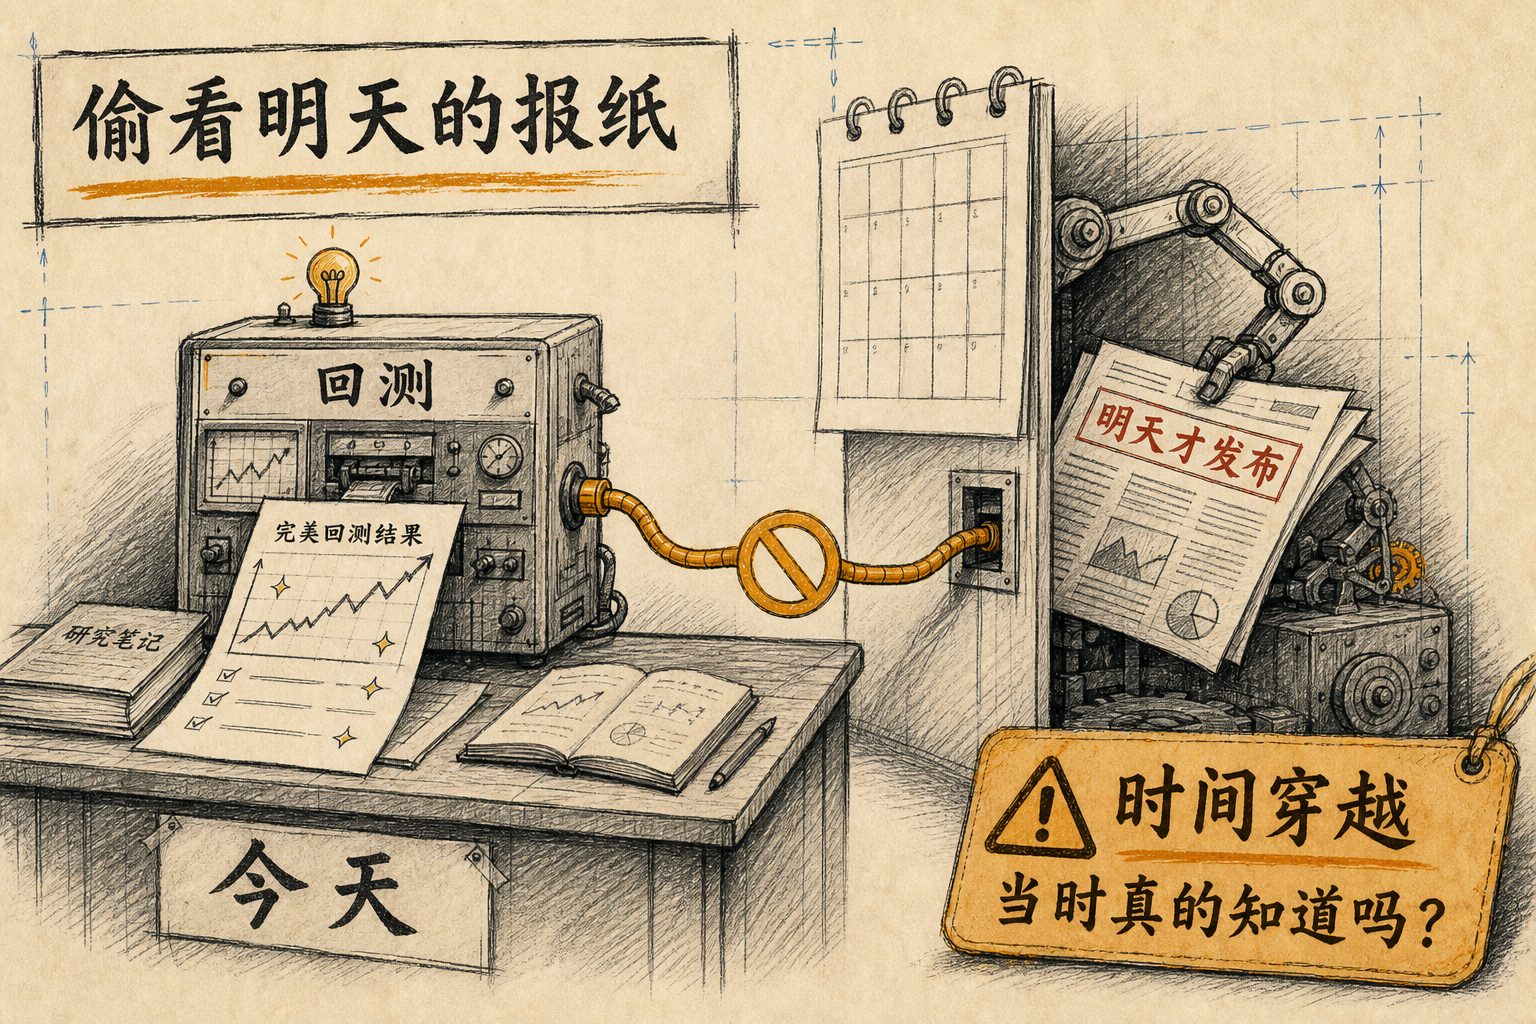
九、回测结果是真的,还是被数据泄漏制造出来的?
两种情况都存在。关键不只是训练集和测试集有没有分开,而是整个历史信息集是否真的属于当时。
最容易理解的前视偏差,是把未来价格、未来财报或尚未公开的文件放进模型。但更隐蔽的污染至少还有三种。
污染一|事后特征选择
Li、Rossi、Yan和Zheng(2025)在《Machine Learning from a “Universe” of Signals》中,没有只使用学术界后来发表并证明有效的一小组异常,而是从投资者当时可以构造的18,113个基本面信号出发。1987—2019年的样本外结果显示,这种实时信号宇宙中的机器学习策略仍有经济价值,但夏普率明显低于使用事后精选特征的经典研究。
更关键的是,当作者把已发表异常重新输入相同机器学习流程时,较高表现又能被复现。这说明一些令人惊艳的ML结果,不只来自算法,也来自研究者已经知道哪些变量值得喂给算法。
污染二|数据修订
从数据库下载的宏观数据,往往已经经过多轮修订。Ghysels、Horan和Moench(2018)在《Forecasting through the Rearview Mirror》中比较最终修订数据与投资者当时真正看到的实时数据。以非农就业为例,在收益率曲线因子基础上加入最终数据,2年期国债预测回归的调整后R²由19%提高到25%;改用实时数据,只提高到21%,而且非农变量不再显著。
宏观信息的预测贡献,也从最终数据中的22%降到实时数据中的7%。组合结果同样显示,最终数据带来的夏普改善通常强于实时数据,后者多不显著。
这意味着,把事后看到的“正确历史”放回过去,会赋予历史投资者当时并不存在的信息。
污染三|LLM训练污染
即使提示词里只放历史新闻,普通大模型也可能在预训练阶段读过后来的事件、结局和解释。未来知识已经进入模型参数,仅靠删除提示词中的日期无法消除。
Kelly、Malamud、Schwab和Xu(2026)为此训练了point-in-time语言模型。他们按时间过滤FineWeb语料,保存逐月模型检查点;从2014年开始,每年的新闻只能由上一年年底已经存在的模型生成嵌入。这样,模型权重和输入信息都不能越过预测时点。
结果很有启发:严格时间隔离后的模型仍能产生正的样本外投资信号,并且与使用完整未来语料的同架构模型表现接近。这既证明了LLM回测必须处理训练泄漏,也否定了另一个极端结论——文本预测力并不一定全部由“偷看未来”造成。
所以,“样本外”只是回测审计的第一步。投资者还要检查:特征集合是否依据事后发表或事后验证的结果筛选,数据库是不是历史版本,文件何时真正公开,模型训练和微调语料截止到哪一天,一共尝试过多少模型,以及是否只报告最好结果。
这部分文献已经足够支持一个明确结论:未经历史信息集审计的高夏普比率不可信;但不能因此反过来说,所有AI回测都是假的。
十、海外有效的AI策略,为什么到了A股可能失效?
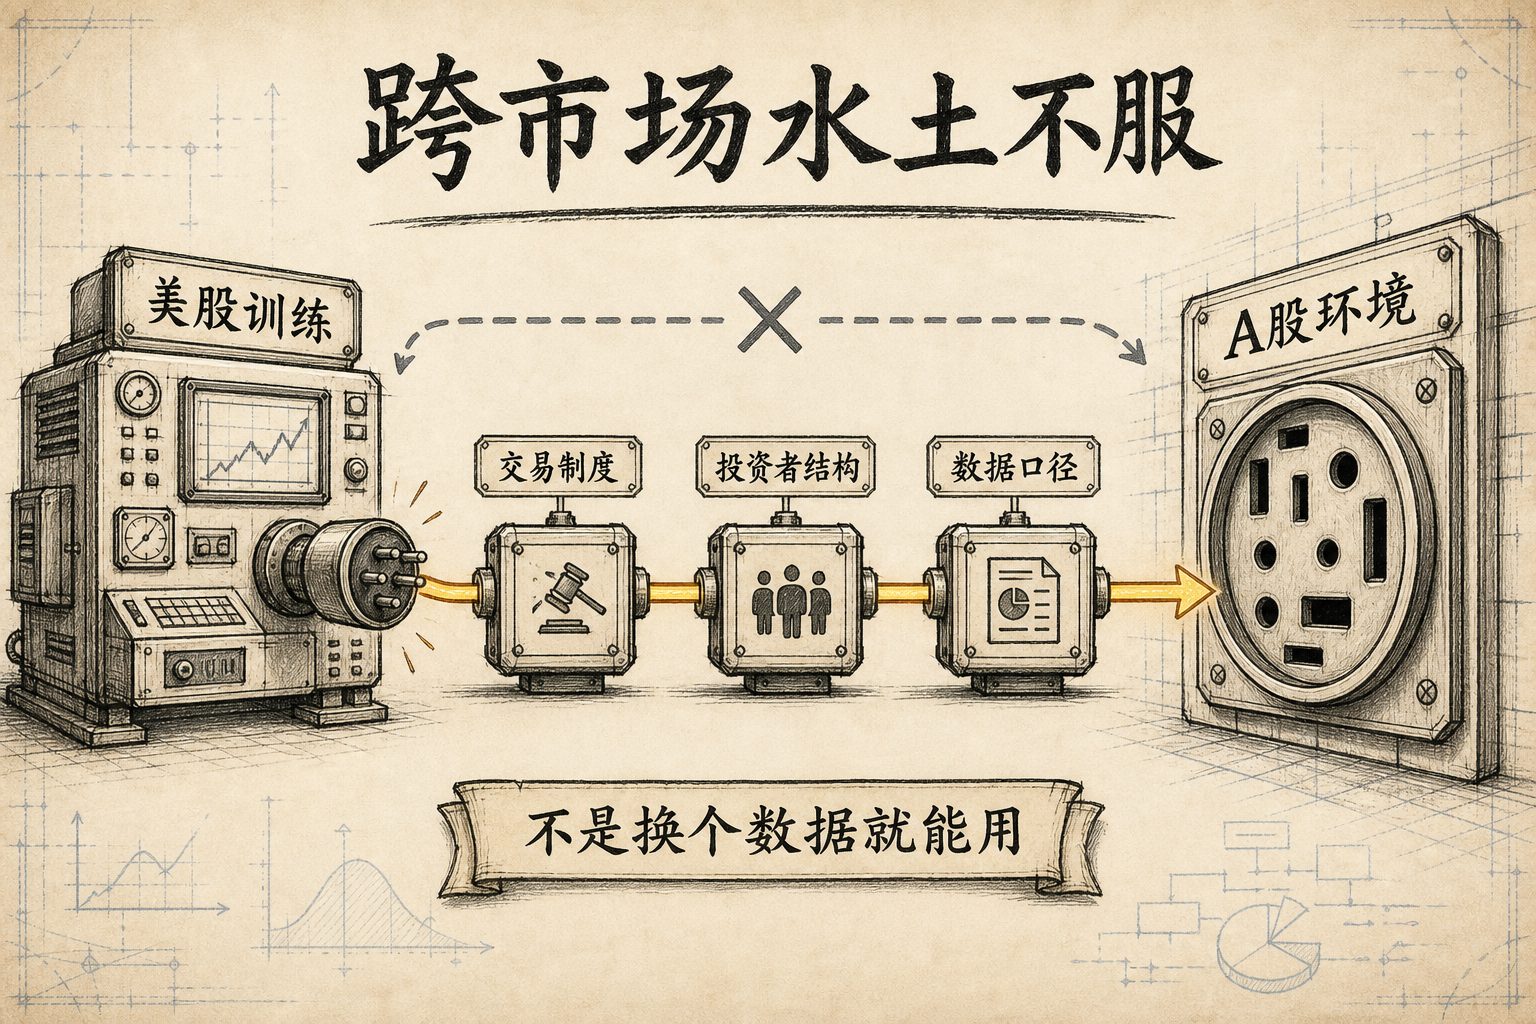
同一条信息如何进入价格,取决于市场制度和投资者结构。模型可以复制,市场环境不能复制。
A股与美股在卖空约束、涨跌停制度、散户占比、流动性结构、财报披露、新闻传播和交易成本上都有差异。这些差异不只是模型外部环境,它们会直接改变标签、特征重要性和策略可实施性。
Leippold、Wang和Zhou(2022)的中国股票机器学习研究发现,中国市场最重要的预测信息集中在流动性、异常换手、本地趋势和波动特征。部分在美国研究中重要的公司特征,到了中国排名明显靠后。中国市场的机器学习样本外R²并不弱,但收益更多来自小盘和交易摩擦较高的股票;卖空限制又使论文中的长空组合难以直接实现。
Zhou、Fan和Xue(2024)使用中文财经新闻训练模型,也发现正面和负面新闻的价格反应并不对称,这与卖空约束和市场结构有关。即使考虑涨跌停和交易成本,部分文本信号仍存在,但等权组合与价值加权组合差异很大,说明收益高度依赖小公司。
Du等人(2023)把美国市场中使用异常预测整体市场收益的方法应用到中国,结果同样不是“全部成功”或“全部失败”:Combine-OLS和Combine-ENet仍有样本外预测能力,另外几种方法却失效。这是很有价值的外部样本检验,但仍不是“美国模型直接部署、本地重新训练、迁移学习”三种方案的严格对照。
因此,把海外AI研究应用到A股,至少要重新处理:
- 中文文本和本地披露语境;
- 财务数据真实发布时间;
- 卖空、涨跌停和停牌约束;
- 微盘股、壳价值和上市制度;
- 交易成本、容量和投资者结构。
海外论文可以提供候选机制,却不能替代本地重训和重新验证。现有证据也不支持“AI在A股普遍比美股更有效”或相反的笼统判断。
即使信号通过了本地验证,它仍然只是一项预测。下一步才是投资中最容易被忽略的环节:把预测转化为组合和仓位。
十一、怎样把AI预测转化为组合和仓位?
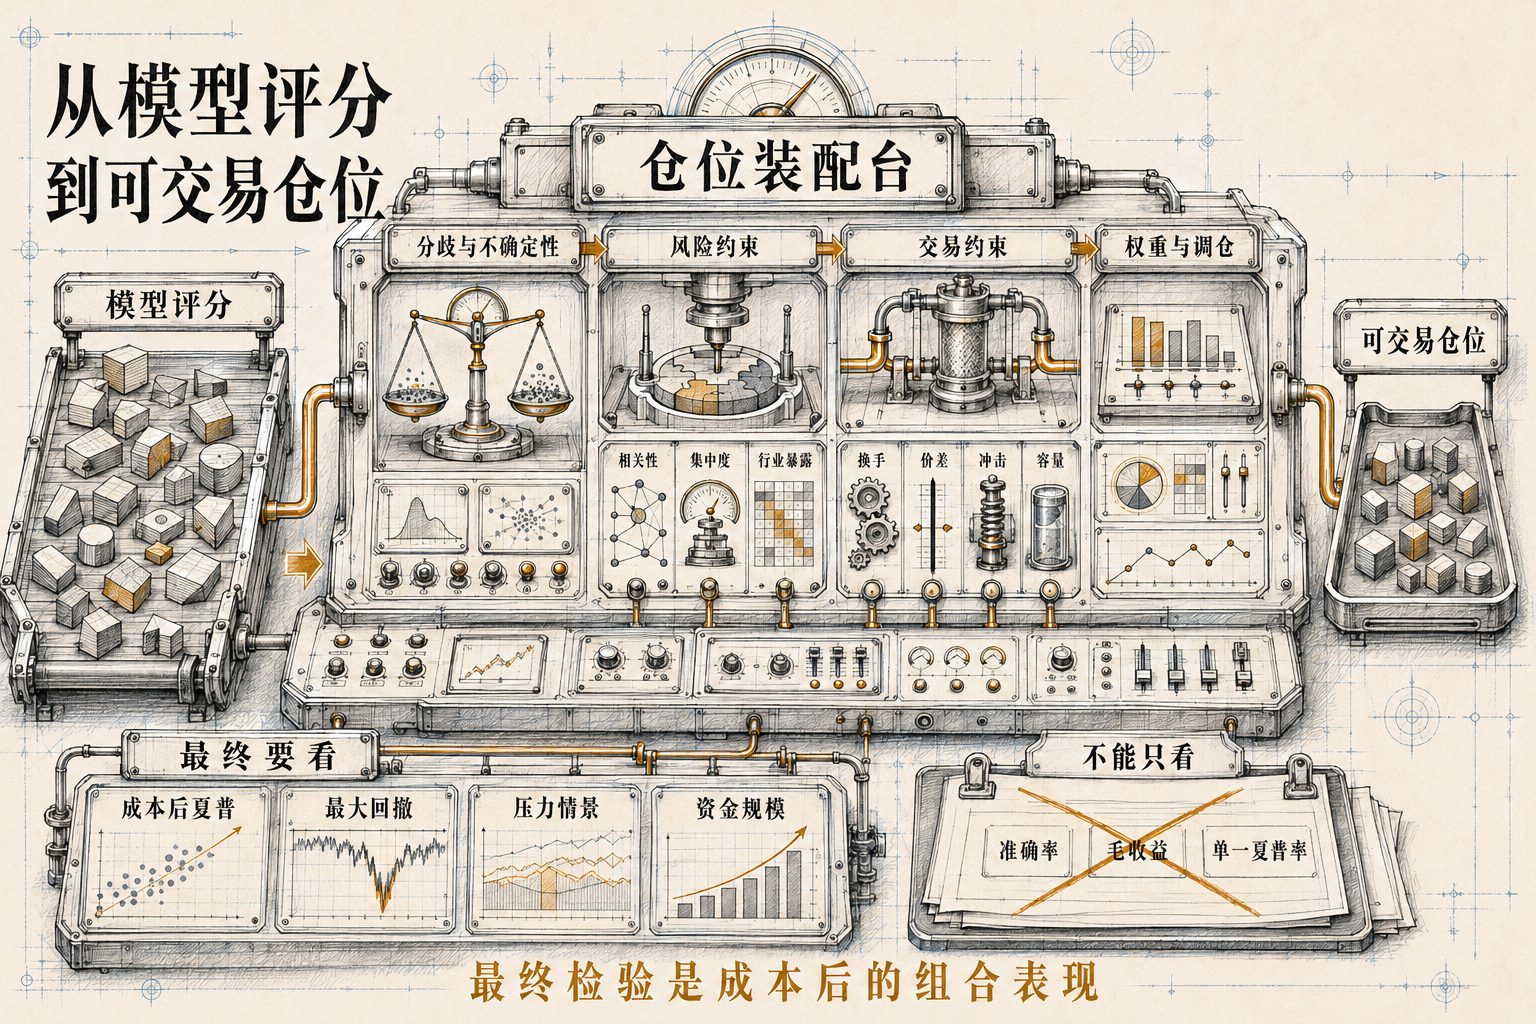
模型评分只是原材料。真正决定投资结果的,是怎样把评分变成权重、风险预算和调仓规则。
如果只把预测收益最高的股票全部买入,组合可能集中在同一行业、同一风格或最不容易交易的一批小股票。预测误差也会在优化器中被放大:预期收益只差一点,最优权重却可能从零跳到极端仓位。
因此,从预测到组合至少要经过相关性、集中度、卖空、换手、成本、尾部风险、资金规模和投资者风险偏好的约束。
《Machine Learning and the Implementable Efficient Frontier》直接学习公司特征到组合权重的映射,并把成本和市场冲击放进目标函数。它说明同一个预测信号,对不同规模投资者并不存在同一套最优持仓;资金越大,组合越需要牺牲毛收益来降低冲击(Jensen et al., 2026)。
《Ambiguity with Machine Learning》则处理另一种问题:当投资者连预期收益模型本身都不确定时,不能只用历史协方差衡量风险。作者把模型歧义单独写进组合目标。其样本包含股票、长期国债、黄金和行业组合,使用134个宏观、金融和文本变量,并采用实时宏观数据避免修订偏差。歧义厌恶组合在危机前更保守,冲击出现后更多转向债券和黄金,样本外效用高于普通均值—方差组合(Ghysels et al., 2021)。
但这篇论文每月调仓,没有完整计入交易成本和市场冲击。因此,它证明了“模型不确定性应该进入仓位”,还没有证明相关收益可以无摩擦兑现。
关于深度学习预测不确定性的Eurodollar期货研究,也显示不确定性可以用于调整头寸大小并改善相对表现,但同样没有覆盖股票投资者关心的换手、买卖价差、冲击和容量全链条(Spears et al., 2021)。
所以,评价AI投资系统时,至少应同时报告:权重集中度、因子和行业暴露、模型分歧、换手、成本后夏普、最大回撤、资金规模以及压力情景下的仓位变化。只报告预测准确率,甚至只报告毛收益,都没有走完从模型到投资的最后一公里。
但单个组合能够控制风险,不代表许多机构同时采用相似策略时,市场整体仍然稳定。这就引向最后一问。
十二、AI普及后,如何识别策略同质化和拥挤?
先把“优势衰减”和“系统性拥挤”分开。前者意味着同一种方法普及后alpha变少;后者意味着相似持仓和退出动作在压力期相互放大。
第五问关心的是单个投资者的优势还能保留多久,第六问解释了系统性风险的形成机制;这一问更实际:当风险开始积累时,投资者能从哪里看到迹象?
现实中可能存在四种同质化来源:共同数据、共同模型、共同服务商和共同风控规则。即使机构独立决策,只要它们观察相似信息、使用相似目标函数,就可能形成相关交易。
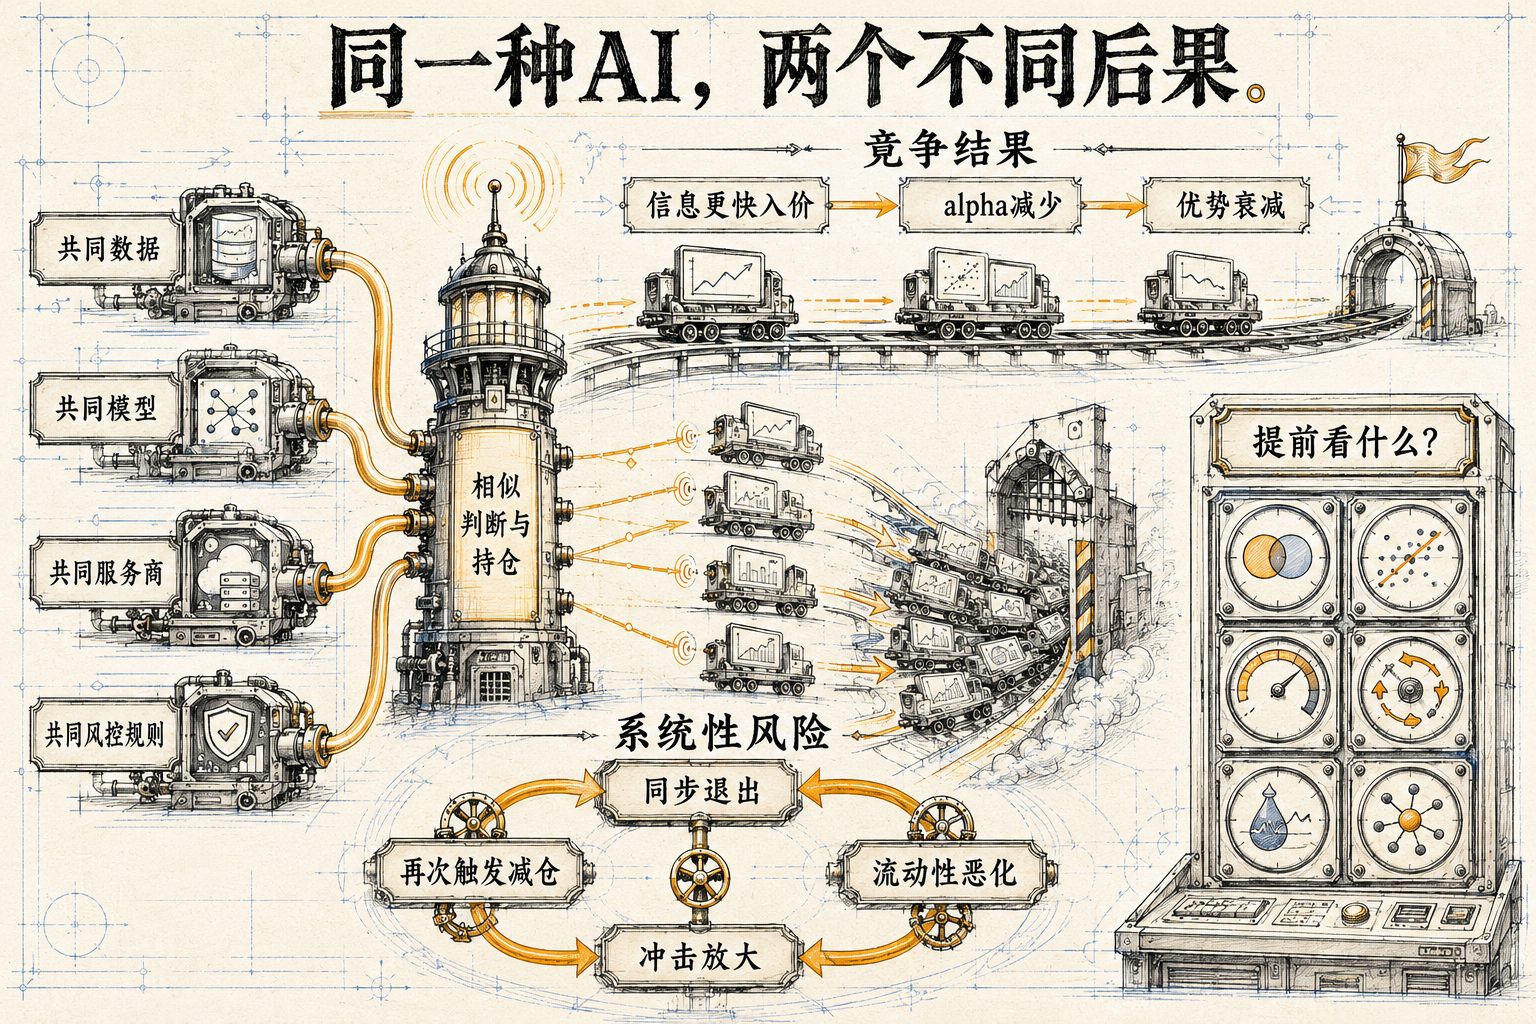
FSB(2024)已经把共同模型、第三方集中和同步退出列为AI金融稳定风险。国际货币基金组织(International Monetary Fund,2024;以下简称IMF)观察到,样本中的AI驱动ETF换手明显高于一般主动ETF,三只样本基金在2020年3月市场压力期提高了换手。这只能算描述性证据:样本很小,也不能证明共同模型导致了共同交易。
理论和模拟证据更强地支持机制可能性。AI交易和强化学习做市研究显示,算法无须直接通信,就可能通过市场价格互动形成非竞争行为(Dou et al., 2025;Cont & Xiong, 2024);ECB的智能体研究则表明,Q-learning与LLM代理在赎回博弈中会产生不同协调模式,模型架构本身可能影响过度赎回和脆弱性(Anand et al., 2026)。
《Mimicking Finance》从另一个角度提示了同质化风险。简单AI模型平均能够预测共同基金经理相当比例的买入、持有和卖出方向;越容易被模仿的经理,后续表现越弱。这并不能证明基金都在使用同一种AI,却说明机械、可复制的投资行为更难长期维持超额收益(Cohen et al., 2026)。
个人投资者可以观察六类指标:
- 相似基金和策略的持仓重合度;
- 策略收益相关性是否持续上升;
- 热门信号和主题的资金容量利用率;
- 换手与市场冲击是否同步恶化;
- 压力期流动性是否迅速撤出;
- 多个策略是否依赖相同数据商、模型或风险阈值。
但这里必须守住证据边界:现有研究足以说明AI同质化的机制和风险,却还不能证明现实市场已经出现由LLM交易直接造成的系统性拥挤。把机制上的可能性直接写成已经发生的事实,是证据越界。
结语:AI不会取消投资研究,只会提高研究的审计标准
回到开头的问题:AI到底能不能帮投资者挣钱?
如果一定要给一个短答案:有可能,但它不会自动发生。
AI较为确定的价值,是扩大投资者能够处理的信息集,提高研究、编码和信息筛选效率。要把这些能力转化为可持续的超额收益,还必须跨过信息、样本外与时点、成本与组合、部署与组织、扩散与市场反馈五道关口。现有文献既不支持“接入一个通用模型就能稳定赚钱”,也不支持“所有AI回测都是幻觉”这两个极端判断。
每一项看起来漂亮的结果,都要经过五道过滤:
第一道是信息过滤。模型发现的到底是新增信息,还是研究者事后挑选出来的规律?
第二道是时点与样本外过滤。模型在预测时是否只使用当时可得的信息,换到未来时期或其他市场后还能否成立?
第三道是实施过滤。扣除换手、价差、冲击、借券和容量,并加入组合约束后,还剩多少经济价值?
第四道是组织过滤。机构有没有数据、人才、流程、治理和低成本执行,把模型变成稳定能力?
第五道是市场过滤。当越来越多投资者使用相似工具时,优势会不会衰减,行为会不会趋同,风险会不会从单个模型扩散到整个市场?
因此,“AI能不能预测股价”并不是一个足够好的问题。它太容易得到一个漂亮却没有边界的答案。对二级市场投资者,更有用的是继续追问:
它提供了什么以前没有的信息?这些信息在当时真的可得吗?经过样本外、交易成本和容量检验后还剩多少?当别人也开始使用时,我的优势和风险分别会怎样变化?
AI不会让投资变成按一下按钮就自动获得alpha。它首先会提高研究门槛,压缩依赖低效信息处理、粗糙回测和机械规则的优势。真正的变化未必是机器替代投资者,而是投资者必须学会同时审计数据、模型、组合、执行和市场反馈。
市场可能会因为AI变得更快、更有效,也可能变得更相似、更脆弱。对投资者而言,最稀缺的能力或许不再是得到一个答案,而是知道这个答案来自什么信息、在什么条件下成立,又会在什么时候失效。
参考文献
以下采用作者—年份制。已正式发表的论文列出期刊、卷期与页码(或文章号);尚未编入卷期的论文标注为在线优先发表,工作论文和机构报告则保留其版本信息及官方链接。
Aleti, S., Bollerslev, T., & Goldstein, I. (2025). News and asset pricing: A high-frequency anatomy of the SDF. The Review of Financial Studies, 38(3), 712–759. https://doi.org/10.1093/rfs/hhae019
Anand, K., Kazinnik, S., Leonello, A., & Panetti, E. (2026). Financial stability in the age of artificial intelligence: The role of algorithmic architecture. ECB Research Bulletin, No. 143. European Central Bank. https://www.ecb.europa.eu/press/research-publications/resbull/2026/html/ecb.rb260521~4d8b12940b.en.html
Bali, T. G., Kelly, B. T., Mörke, M., Rahman, J., & Sialm, C. (2026). Machine forecast disagreement. The Review of Financial Studies, online advance publication. https://doi.org/10.1093/rfs/hhag042
BIS Innovation Hub Nordic Centre. (2023). Project Aurora: The power of data, technology and collaboration to combat money laundering across institutions and borders. Bank for International Settlements. https://www.bis.org/publ/othp66.htm
Buckmann, M., Haldane, A., & Hüser, A.-C. (2021). Comparing minds and machines: Implications for financial stability. Oxford Review of Economic Policy, 37(3), 479–508. https://doi.org/10.1093/oxrep/grab017
Cohen, L., Lu, Y., & Nguyen, Q. (2026). Mimicking finance (NBER Working Paper No. 34849). National Bureau of Economic Research. https://doi.org/10.3386/w34849
Cont, R., & Xiong, W. (2024). Dynamics of market making algorithms in dealer markets: Learning and tacit collusion. Mathematical Finance, 34(2), 467–521. https://doi.org/10.1111/mafi.12401
Dou, W. W., Goldstein, I., & Ji, Y. (2025). AI-powered trading, algorithmic collusion, and price efficiency (NBER Working Paper No. 34054). National Bureau of Economic Research. https://doi.org/10.3386/w34054
Du, Q., Wang, Y., Wei, C., & Wei, K. C. J. (2023). Machine learning, anomalies, and the expected market return: Evidence from China. Pacific-Basin Finance Journal, 82, 102168. https://doi.org/10.1016/j.pacfin.2023.102168
Farboodi, M., Singal, D., Veldkamp, L., & Venkateswaran, V. (2025). Valuing financial data. The Review of Financial Studies, 38(3), 938–980. https://doi.org/10.1093/rfs/hhae034
Financial Stability Board. (2024). The financial stability implications of artificial intelligence. https://www.fsb.org/2024/11/the-financial-stability-implications-of-artificial-intelligence/
Ghysels, E., Horan, C., & Moench, E. (2018). Forecasting through the rearview mirror: Data revisions and bond return predictability. The Review of Financial Studies, 31(2), 678–714. https://doi.org/10.1093/rfs/hhx098
Ghysels, E., Qian, Y., & Raymond, S. (2021). Ambiguity with machine learning: An application to portfolio choice (CEPR Discussion Paper No. 16748). Centre for Economic Policy Research. https://cepr.org/publications/dp16748
Gu, S., Kelly, B., & Xiu, D. (2020). Empirical asset pricing via machine learning. The Review of Financial Studies, 33(5), 2223–2273. https://doi.org/10.1093/rfs/hhaa009
International Monetary Fund. (2024). Advances in artificial intelligence: Implications for capital market activities. In Global Financial Stability Report, October 2024: Steadying the course—Uncertainty, artificial intelligence, and financial stability (Chap. 3). https://www.elibrary.imf.org/display/book/9798400277573/CH003.xml
Jensen, T. I., Kelly, B., Malamud, S., & Pedersen, L. H. (2026). Machine learning and the implementable efficient frontier. The Review of Financial Studies, online advance publication. https://doi.org/10.1093/rfs/hhag022
Kelly, B., Malamud, S., Schwab, J., & Xu, T. A. (2026). Scaling point-in-time language models (NBER Working Paper No. 35247). National Bureau of Economic Research. https://doi.org/10.3386/w35247
Leippold, M., Wang, Q., & Zhou, W. (2022). Machine learning in the Chinese stock market. Journal of Financial Economics, 145(2), 64–82. https://doi.org/10.1016/j.jfineco.2021.08.017
Li, B., Rossi, A. G., Yan, X., & Zheng, L. (2025). Machine learning from a “universe” of signals: The role of feature engineering. Journal of Financial Economics, 172, 104138. https://doi.org/10.1016/j.jfineco.2025.104138
Lopez-Lira, A., & Tang, Y. (2023). Can ChatGPT forecast stock price movements? Return predictability and large language models [Working paper]. SSRN. https://doi.org/10.2139/ssrn.4412788
Ross, L. J., Horn, J., Pilanci, M., Luo, K., & Zhou, G. (2026). Bottom up vs. top down: What does firm 10-K tell us? Journal of Financial Markets, 79, 101070. https://doi.org/10.1016/j.finmar.2026.101070
Sheng, J., Sun, Z., Yang, B., & Zhang, A. L. (2026). Generative AI and asset management. The Review of Financial Studies, online advance publication. https://doi.org/10.1093/rfs/hhag050
Spears, T., Zohren, S., & Roberts, S. (2021). Investment sizing with deep learning prediction uncertainties for high-frequency Eurodollar futures trading. The Journal of Financial Data Science, 3(1), 57–73. https://doi.org/10.3905/jfds.2020.1.049
Wang, Y., & Lera, S. C. (2026). Meta-learning for return prediction in shifting market regimes. Journal of Financial Markets, 79, 101042. https://doi.org/10.1016/j.finmar.2025.101042
Zhou, Y., Fan, J., & Xue, L. (2024). How much can machines learn finance from Chinese text data? Management Science, 70(12), 8962–8987. https://doi.org/10.1287/mnsc.2022.01468