先说结论
同一个 AI,面对三种学生,给出的完全是三种课:零基础的那位几乎看不到公式,备考的那位拿到了诊断报告和复习计划,研究生那位拿到的是能直接搬进习题课的模拟器。但它做的东西也会算错,用之前一定要自己核对一遍。
一、刷到一篇文章,我当场就试了
前几天刷到一位 AI 自媒体博主的文章,说 ChatGPT 上线了一个叫 Intelligent UI(智能交互界面) 的新能力(OpenAI 官方帮助文档也这么叫):在普通的 Chat 对话里,它会根据内容,直接在回答中“长出”图表、按钮、滑块、选择题和小模拟器,而不是只给你一大段文字。
我第一反应是:这不正是学概率统计最需要的吗?中心极限定理、置信区间、两类错误,光看公式很难有感觉,亲手拖一拖参数,往往一下就懂。于是我立刻打开 ChatGPT,拿《概率论与数理统计》试了个遍。
二、怎么触发:三句话说清楚
按那篇文章的说法,再加上我自己的实测,要点就三条:
- 用普通 Chat 模式,不是 Work,也不是语音。
- 别只说“给我讲讲”,要明确说“请生成一个可以操作的交互模块”,并且列出你想要哪些控件,比如“用滑块调整样本量”“最后给我 3 道题”。
- 如果它还是只回了文字,就追问一句:“不要用静态文字回答,请把它改成可以点击、拖动参数并实时反馈的交互学习模块。”
如果总出不来,可以检查一下 设置 → 个性化 → Layout and Visuals 是否选了 Simple(这是官方文档里的说法,我没实测)。
我这次运气不错,每一轮的第一次回复就直接出了交互模块,没用上那句追问。代价是慢:每个模块要等 2 到 5 分钟。另外,文章里提到的 Study(学习)模式,我在网页版的“+”菜单里没找到,所以下面全部是在普通 Chat 里完成的。还要提醒一句:模块里的模拟每跑一次结果都会略有不同,下文的模拟读数都只是我某一次运行的截图。
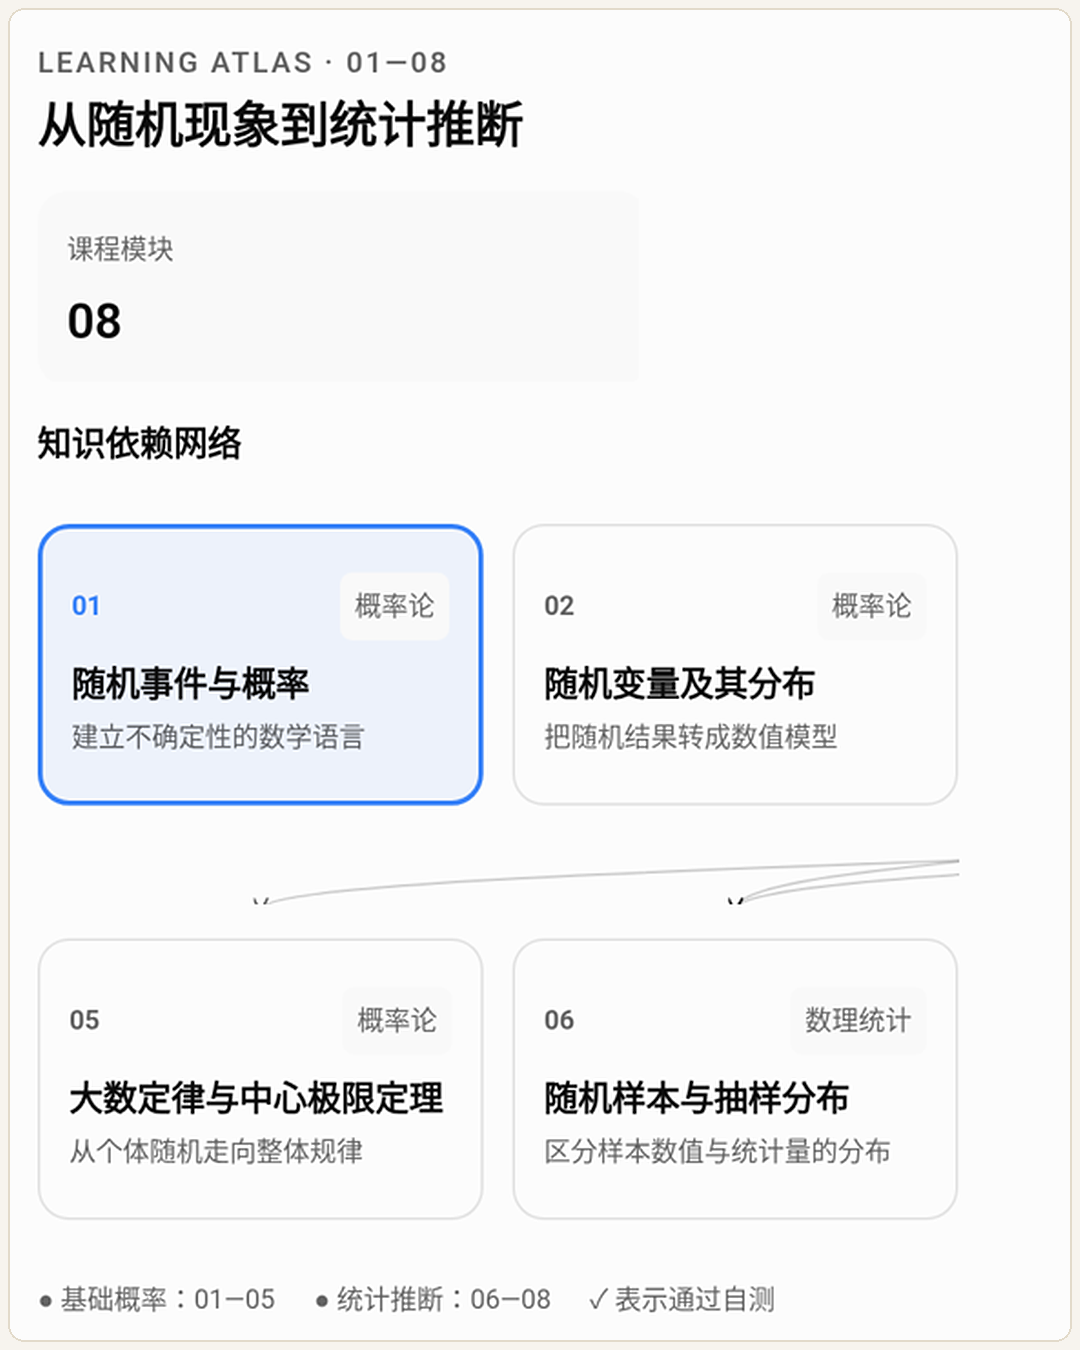
先热个身。我让它画一张整门课的“课程地图”,它把课程拆成 8 章,用箭头标出哪章依赖哪章,选中一章,下方会展开这一章的讲解,从“一句话直觉”讲起。
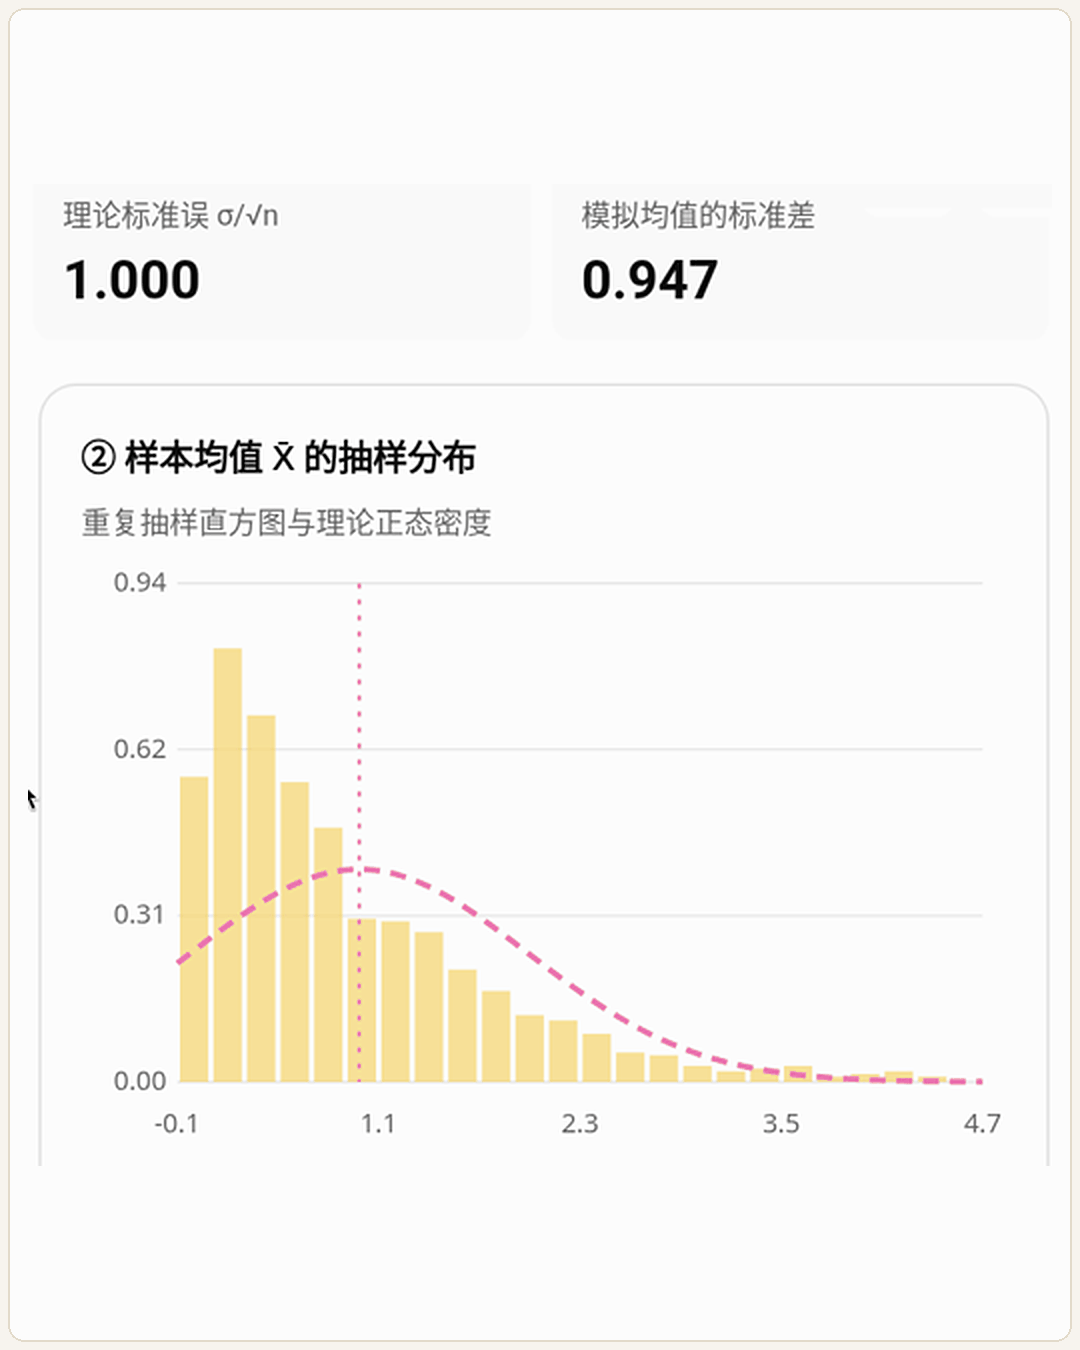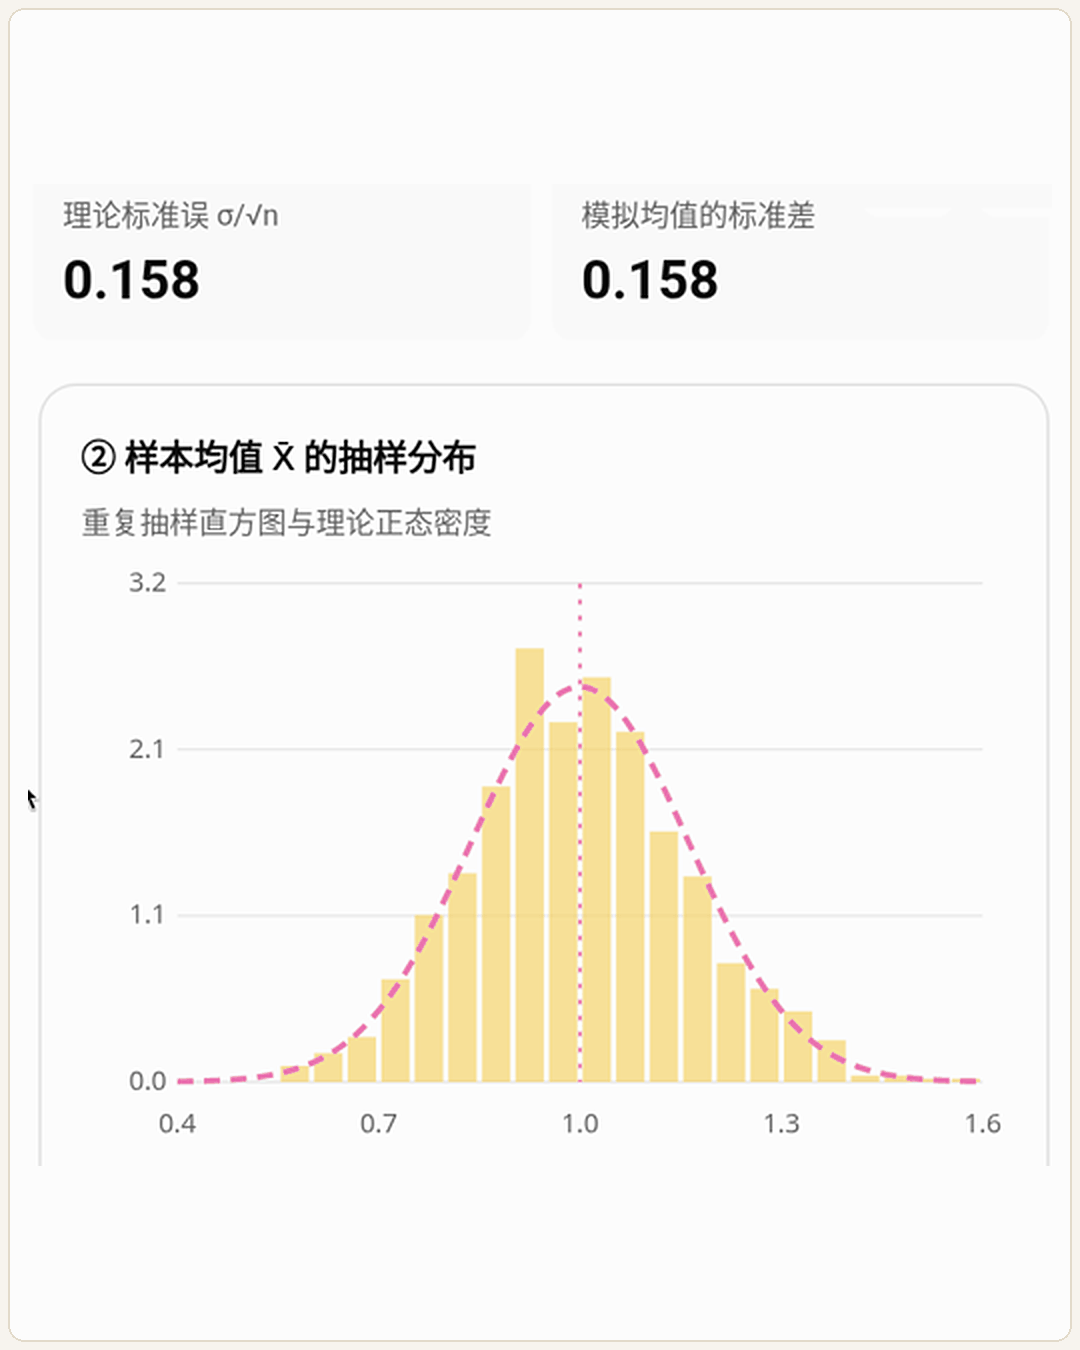
接着要了一个中心极限定理模拟器。总体选“指数分布”(一个明显右偏的分布),样本量 n 拖到 1,样本均值的直方图还是歪的;拖到 40,已经很接近钟形。它还实时对比标准误:n = 1 时,理论值 1.000,模拟出来 0.947;n = 40 时,理论值 1/√40 ≈ 0.158,模拟出来也是 0.158。
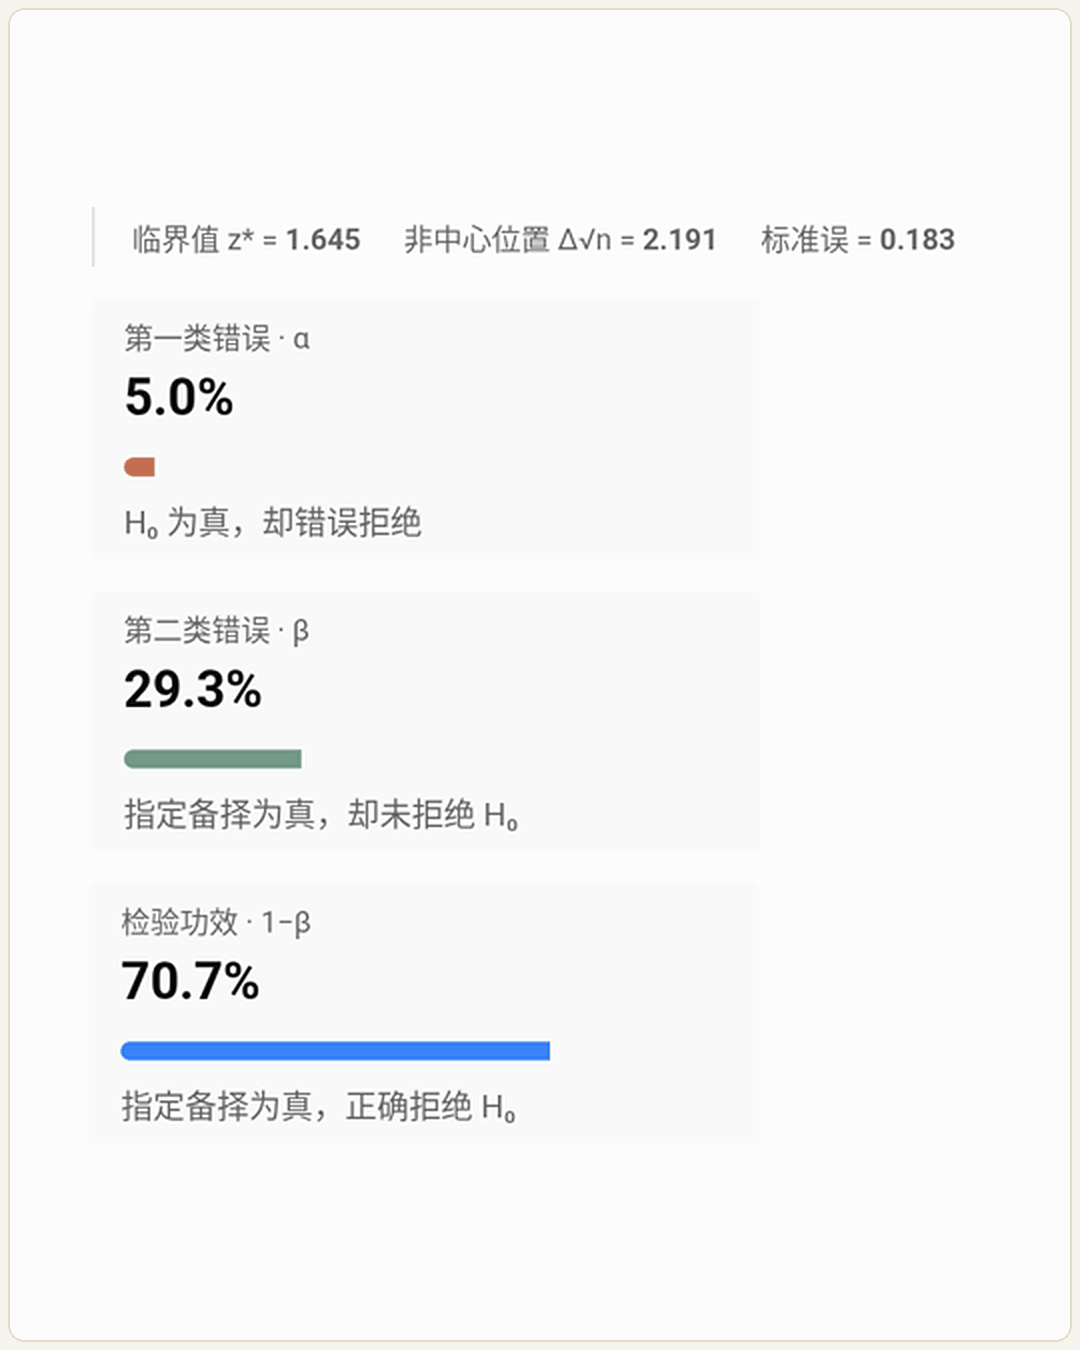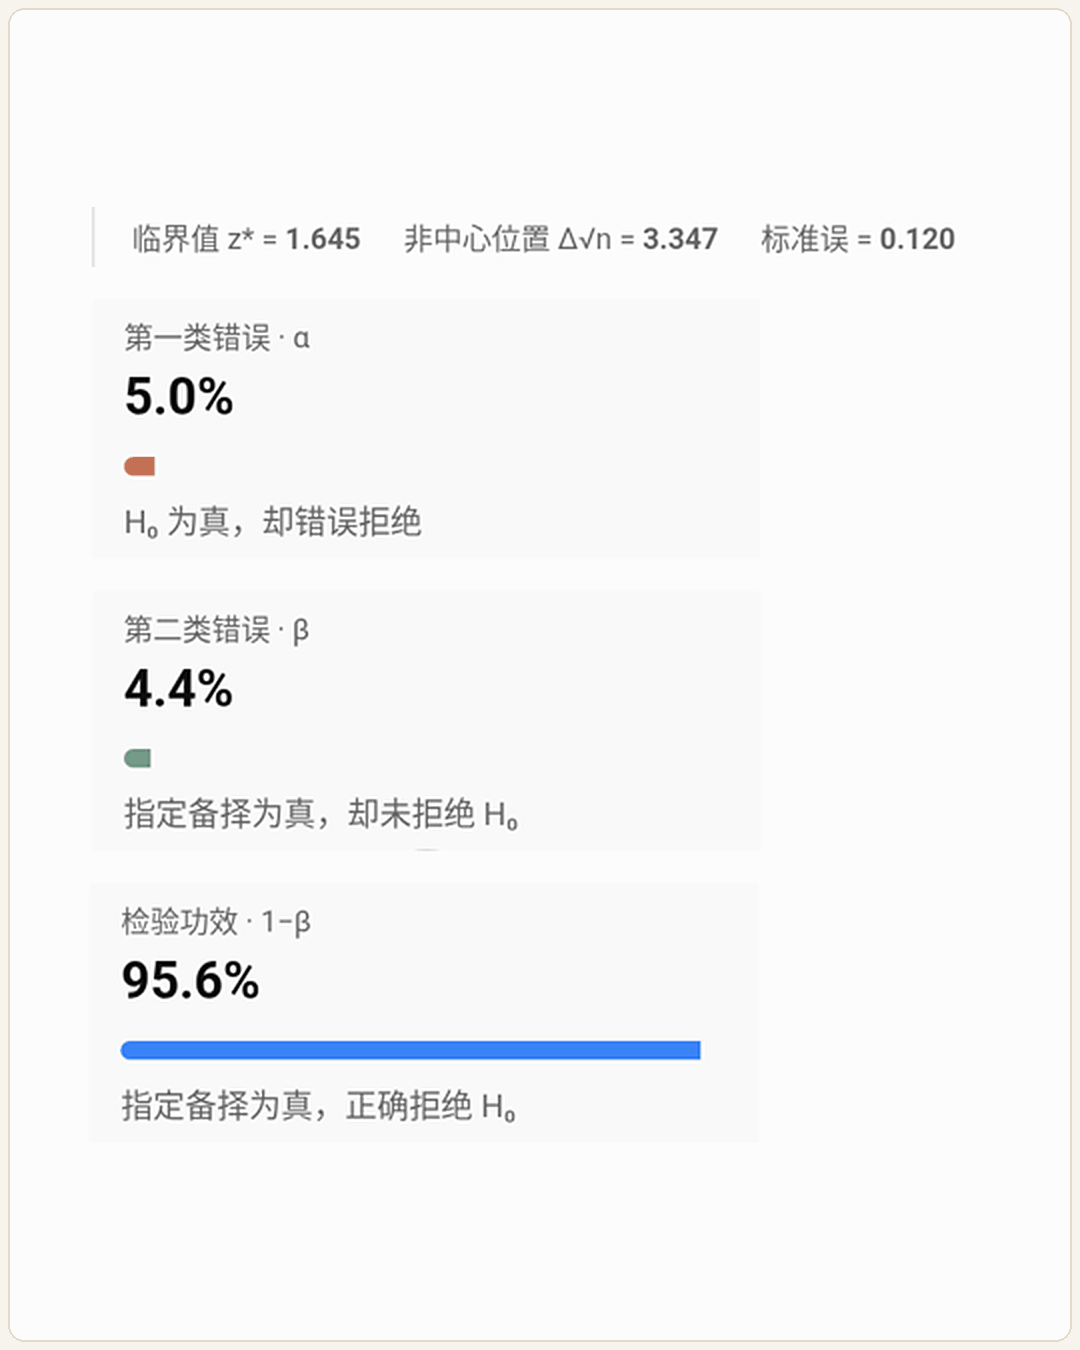
第三个热身是假设检验的“功效实验室”:拖动真实效应 Δ、样本量 n 和显著性水平 α,两类错误的面积实时变化。我验算了一下:Δ = 0.4、n = 30、α = 0.05 时,它给出的功效是 70.7%;把 n 加到 70,功效升到 95.6%;再把 α 放宽到 0.075,功效到 97.2%。三个数我按单侧 Z 检验(σ = 1)用正态分布表一一算过,全对。
三、三种学生,三种完全不同的课
我开了三个新对话,分别扮演三种学生。这三位都是我角色扮演出来的,提问时只改开头的自我介绍和需求,其余尽量保持一致,看看它会不会“因材施教”。
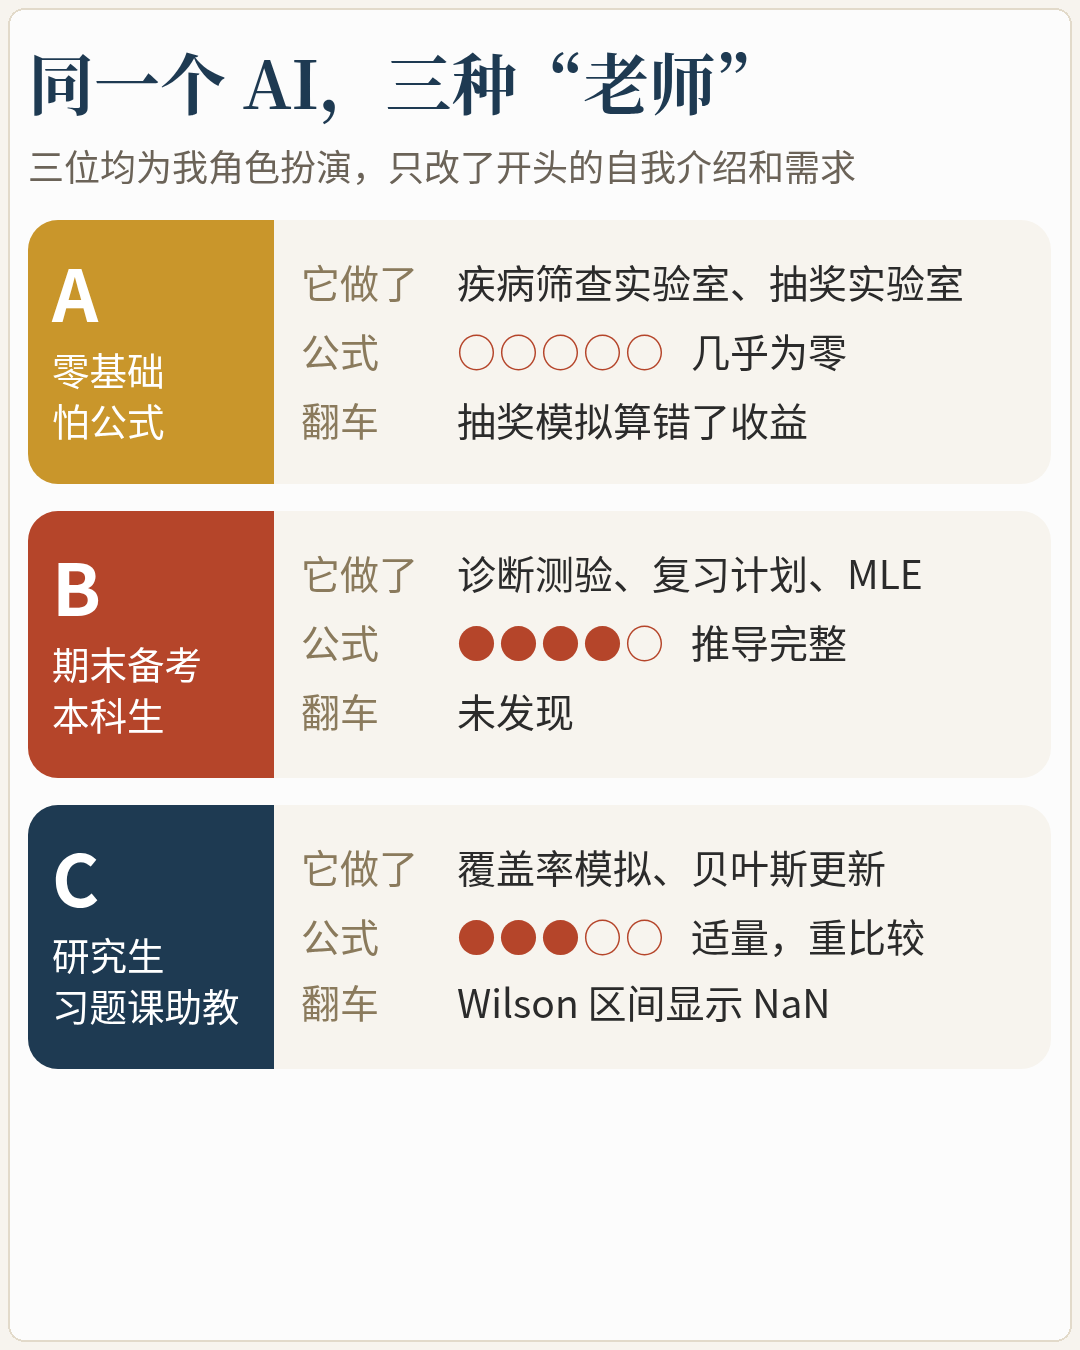
学习者 A:经管专业大一,看到公式就头疼
我跟它说:我是零基础,怕公式,想用生活里的例子学概率。
它给我做了一个“疾病筛查实验室”。第一步不讲道理,先让我猜:每 100 人里有 1 人患病,检测能查出 90% 的病人,也能正确排除 95% 的健康人。一个人检测呈阳性,他真患病的可能性有多大?选项是 90%、50%、15% 和“不知道”。
很多人会选 90%。可答案是 15.4%。
然后它让我自己拖“患病率”滑块,下面一万人的分组人数(患病/健康两组条形图)跟着实时变化:
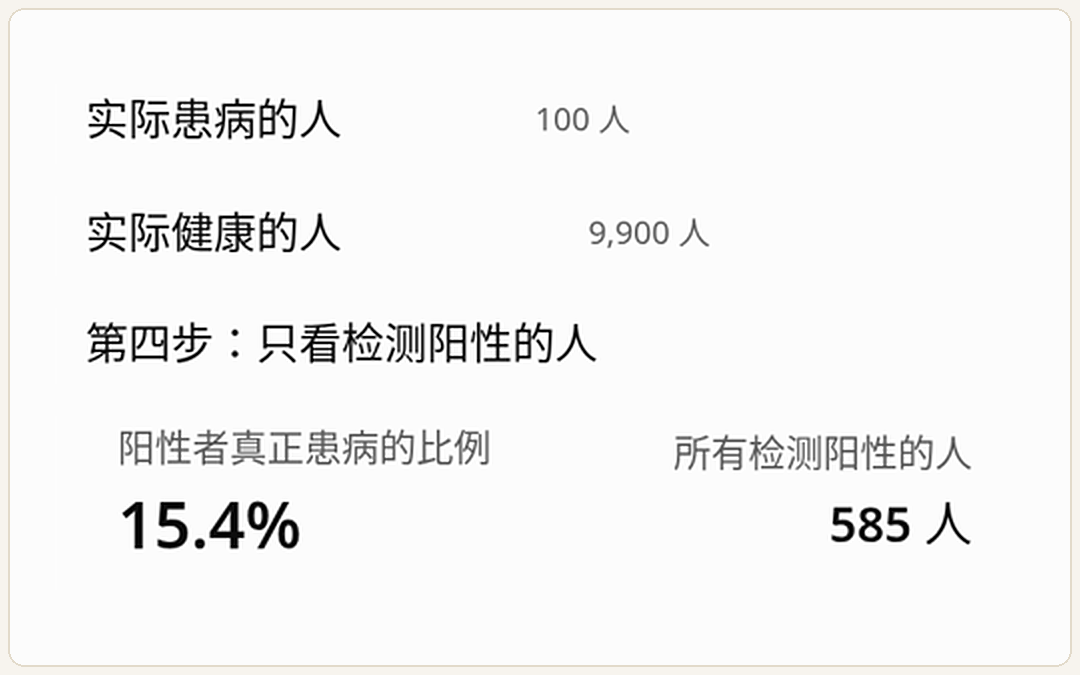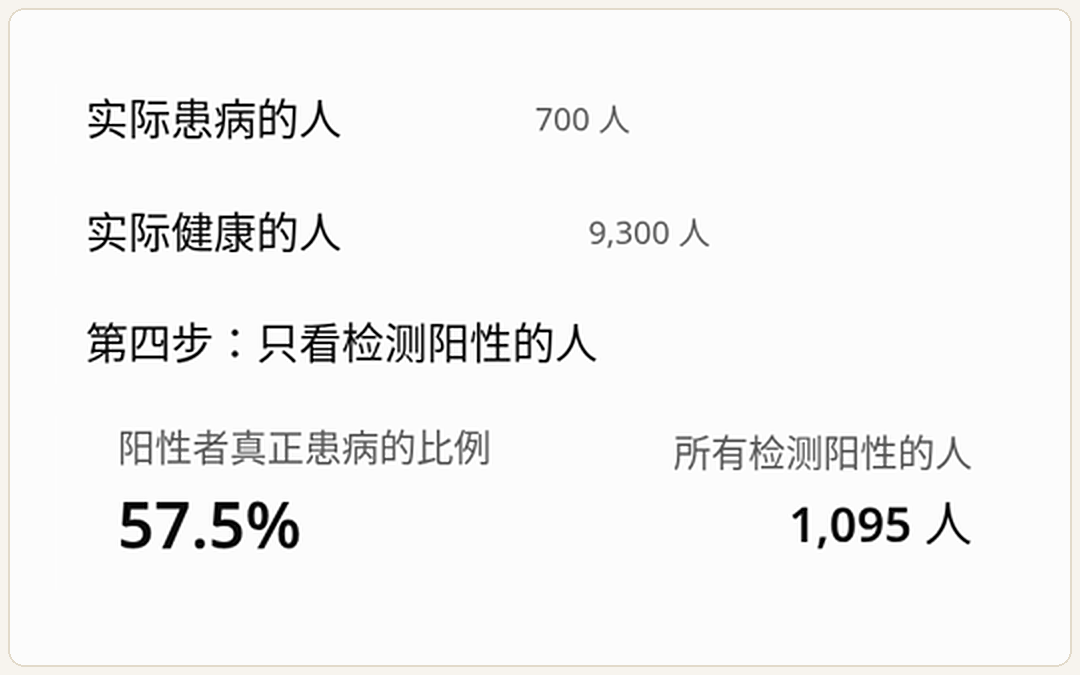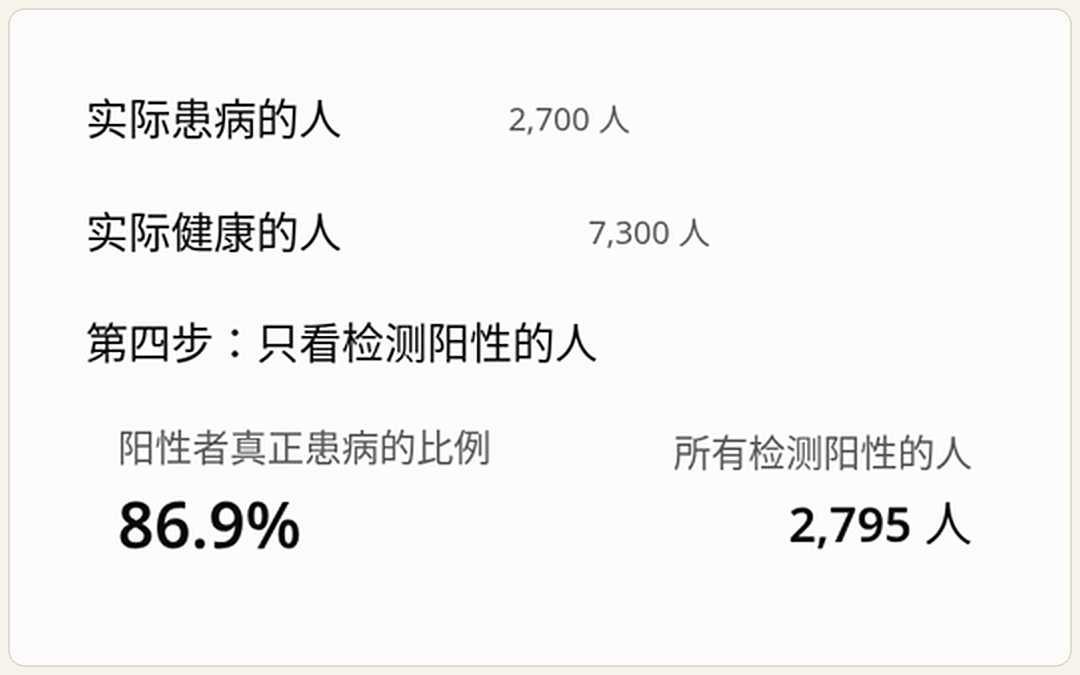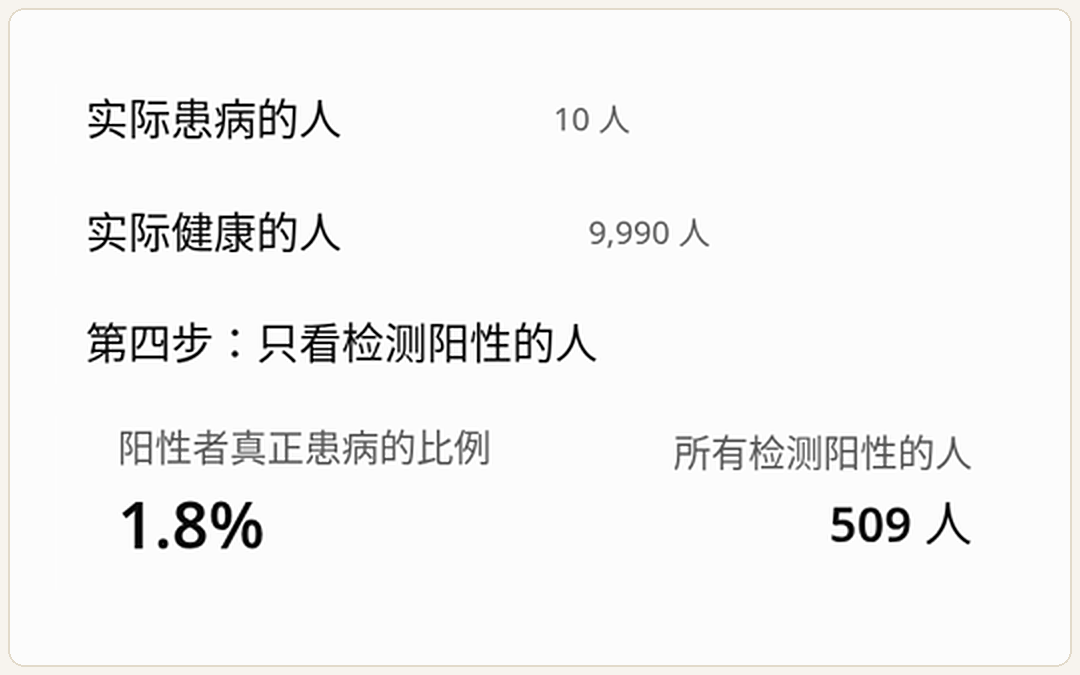
- 患病率 1%:阳性者里真患病只占 15.4%
- 患病率 7%:57.5%
- 患病率 13%:72.9%
- 患病率 27%:86.9%
- 罕见病 0.1%:只剩 1.8%
拖完这一圈,不用任何公式也能明白:检测阳性有多可信,很大程度取决于这个病本来有多常见。这正是贝叶斯公式想说的事,但整个模块里一个公式都没出现。
我把这 5 个读数用贝叶斯公式自己算了一遍,结果和它给的完全一致:
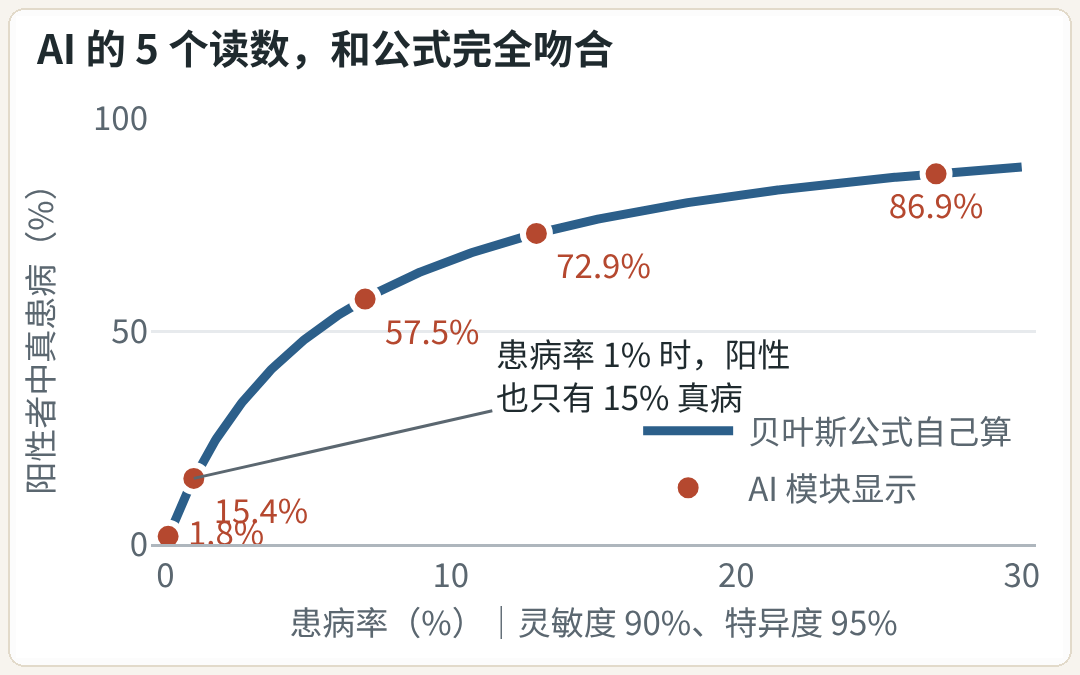
这一课,我给满分。不过 A 的第二个模块(抽奖)就翻车了,后面细说。
学习者 B:两周后期末考试的本科生
我说:两周后期末,请先帮我诊断一下掌握情况。
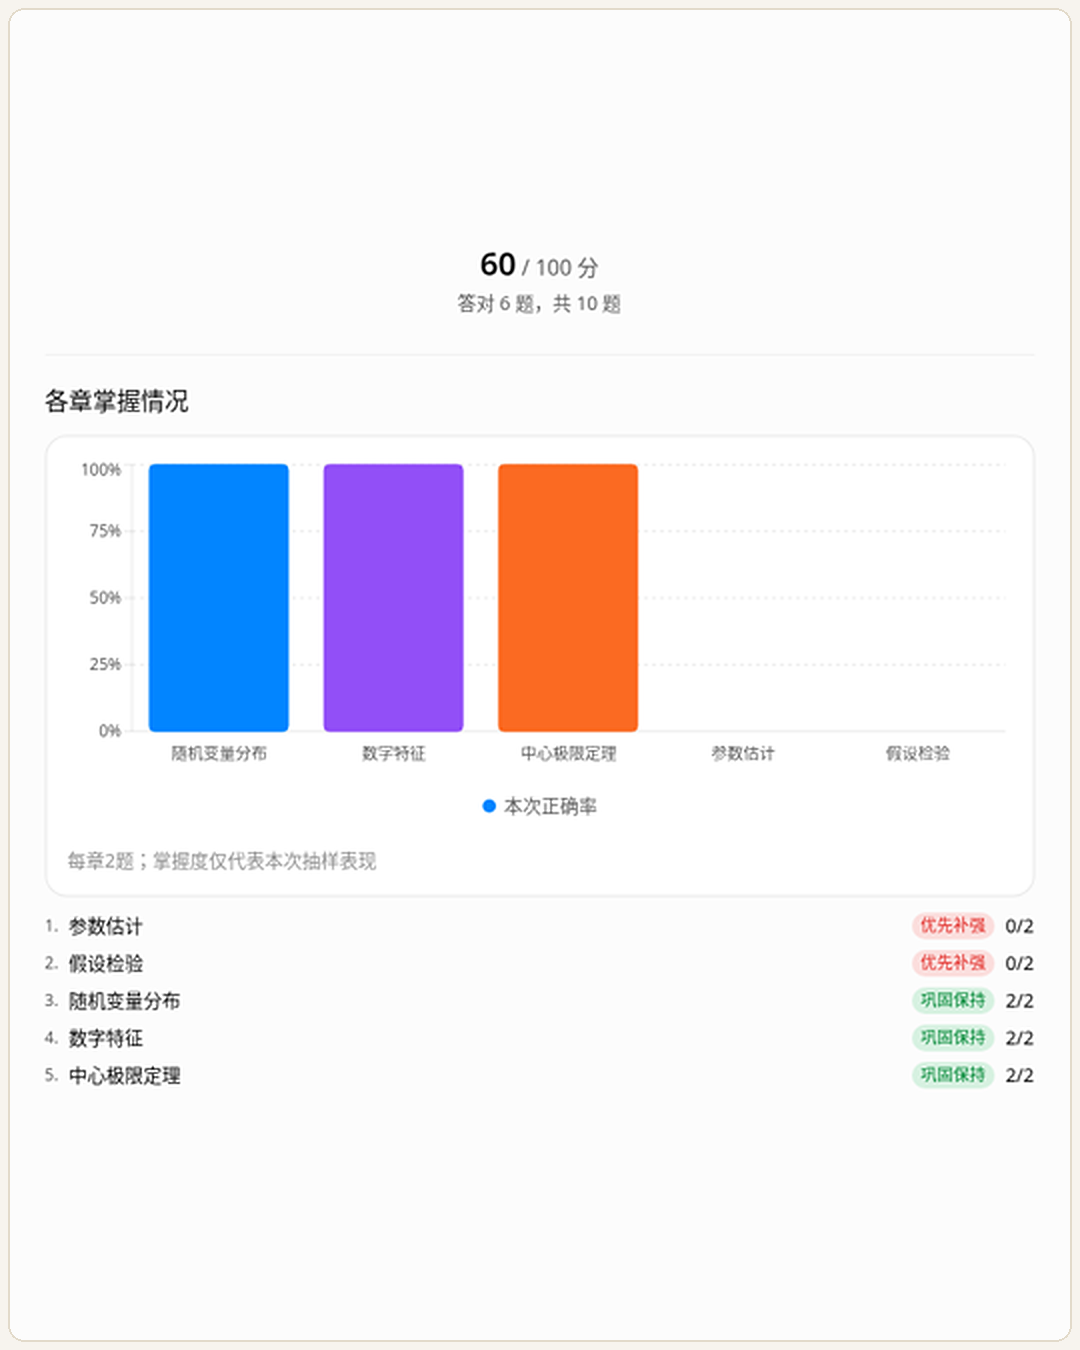
它先出了一套 10 道题的诊断测验,覆盖随机变量、数字特征、中心极限定理、参数估计、假设检验五块。我故意把参数估计和假设检验的题都答错,看它会不会“发现”。
结果:60 分,掌握度柱状图上那两章是空的,复习优先级排成“参数估计 → 假设检验”,还附了一份 14 天复习计划。
我接着说“那就从参数估计开始”。它做了一个最大似然估计(MLE)实验:给定 5 个泊松分布的观测值 2、4、3、5、1,让我拖动参数 λ,看“似然”怎么变。
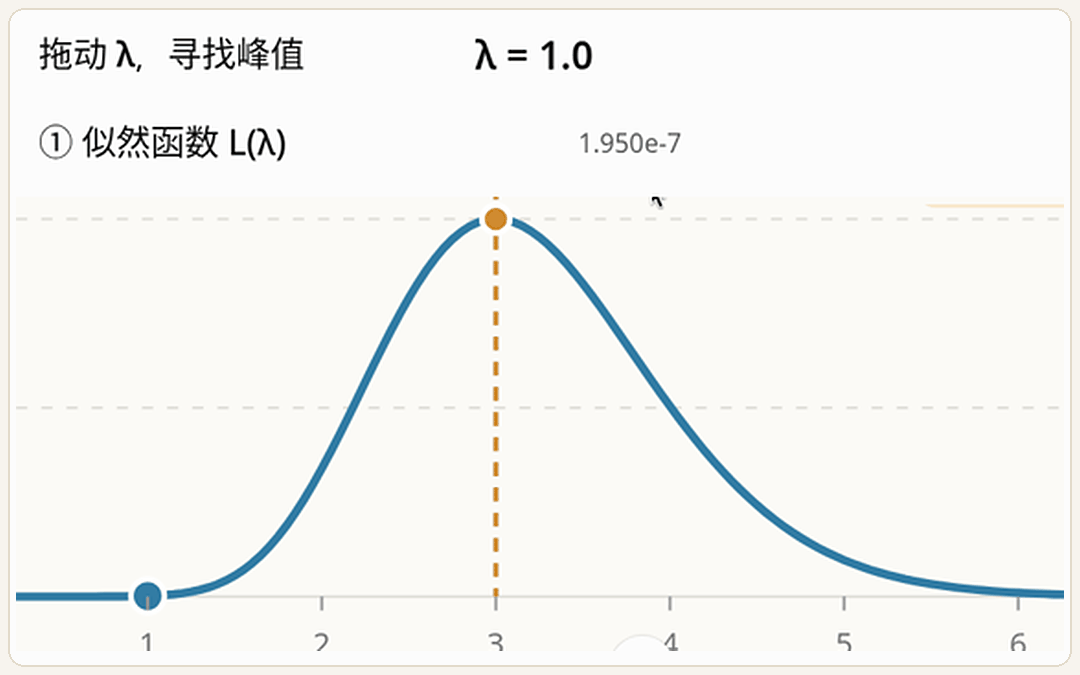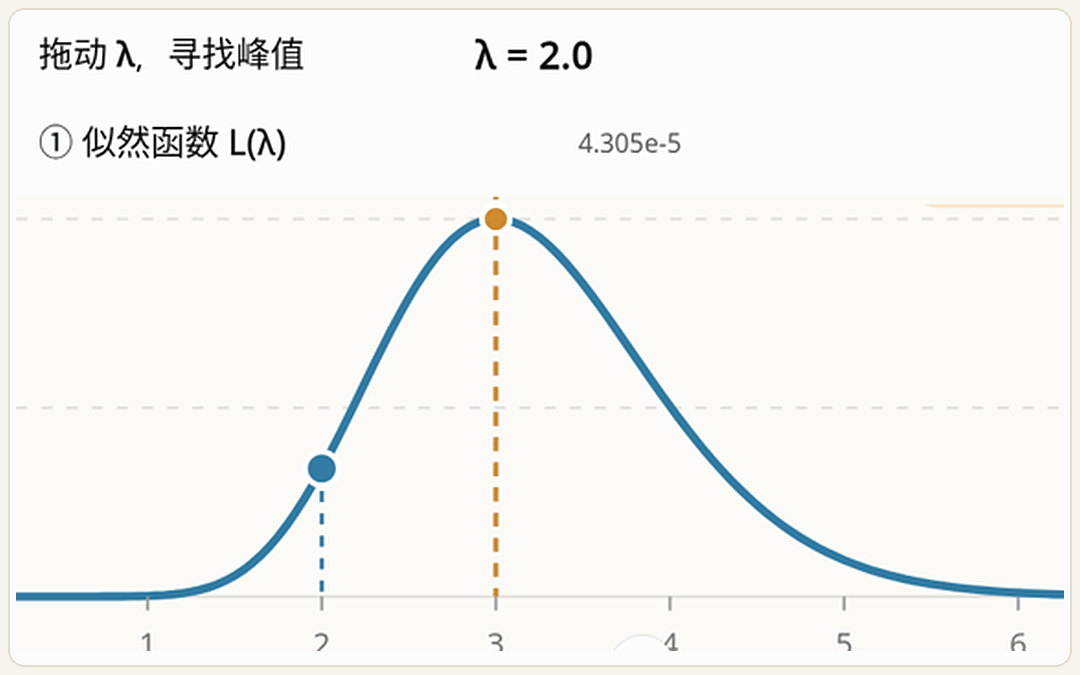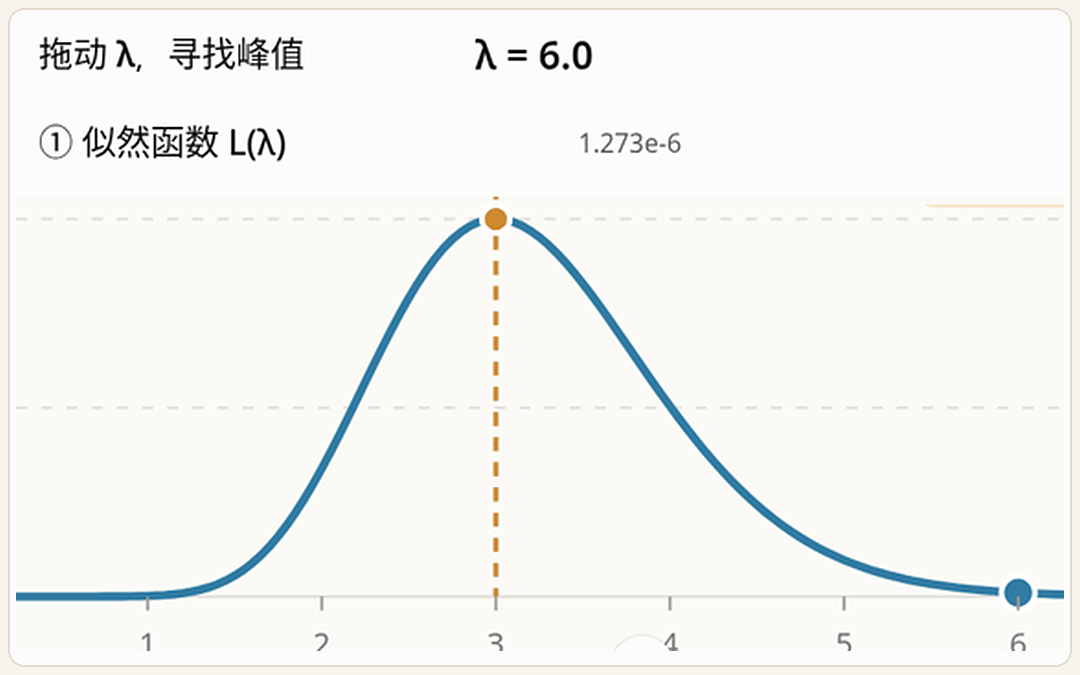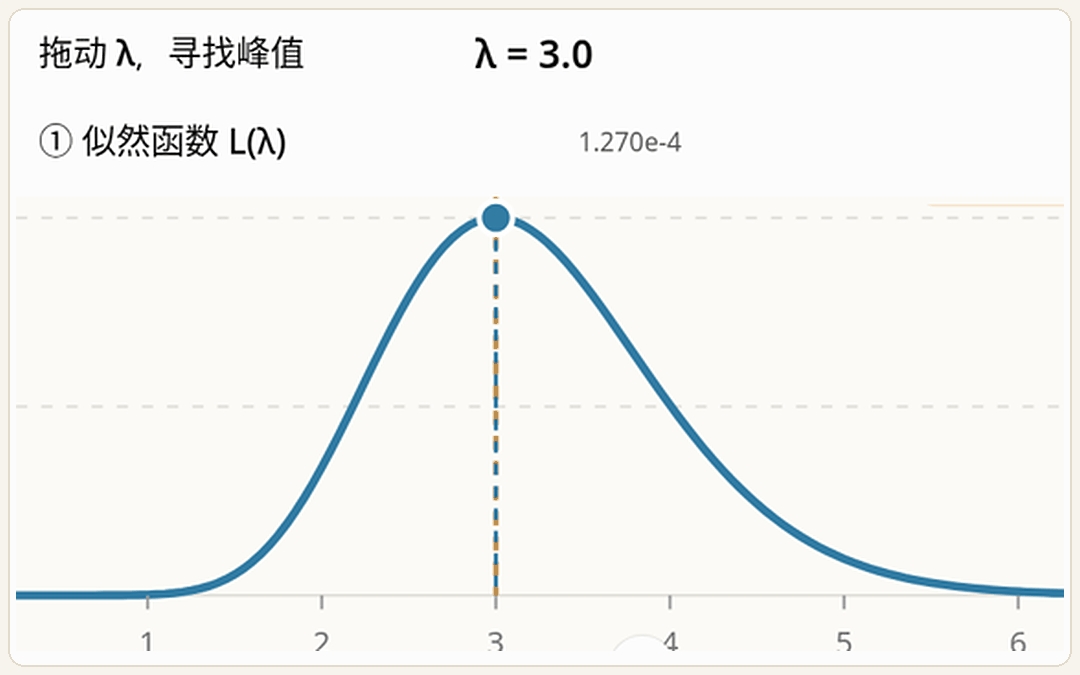
λ = 1 时,相对似然只有约 0.15%;λ = 2 时是 33.9%;λ = 3 时曲线到顶,正好是这 5 个数的平均值;再拖到 λ = 6,又掉回 1.0%。
大白话说,MLE 就是:找一个参数,让“我们手里这批数据出现”的可能性最大。这句话课本上读十遍,不如亲手把滑块拖到山顶一次。
和 A 不同,B 的模块公式很多:似然函数、取对数、求导、令导数为零,一步不少。它显然读懂了“我要考试”这件事。
学习者 C:研究生,兼习题课助教
我说:我要给本科生上习题课,想要一个能在课堂上演示的工具。
它做了一个置信区间覆盖率模拟器:一次抽 100 组样本,每组画一条 95% 置信区间,没盖住真实均值的那条标红。还能把经典的 t 区间和 Bootstrap 区间放在一起比较。
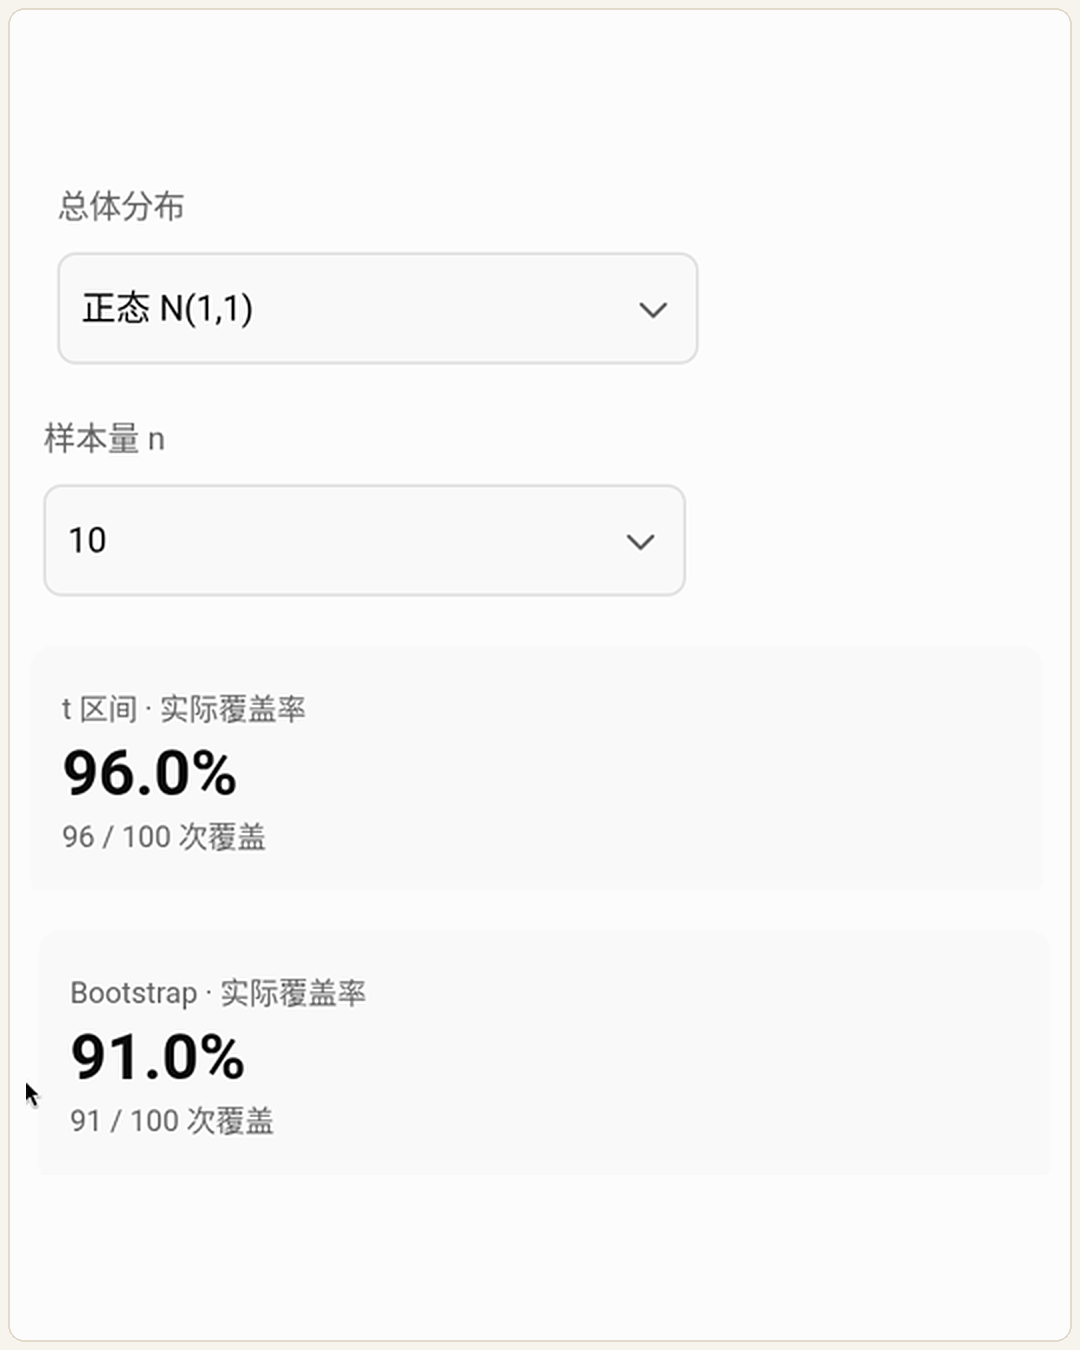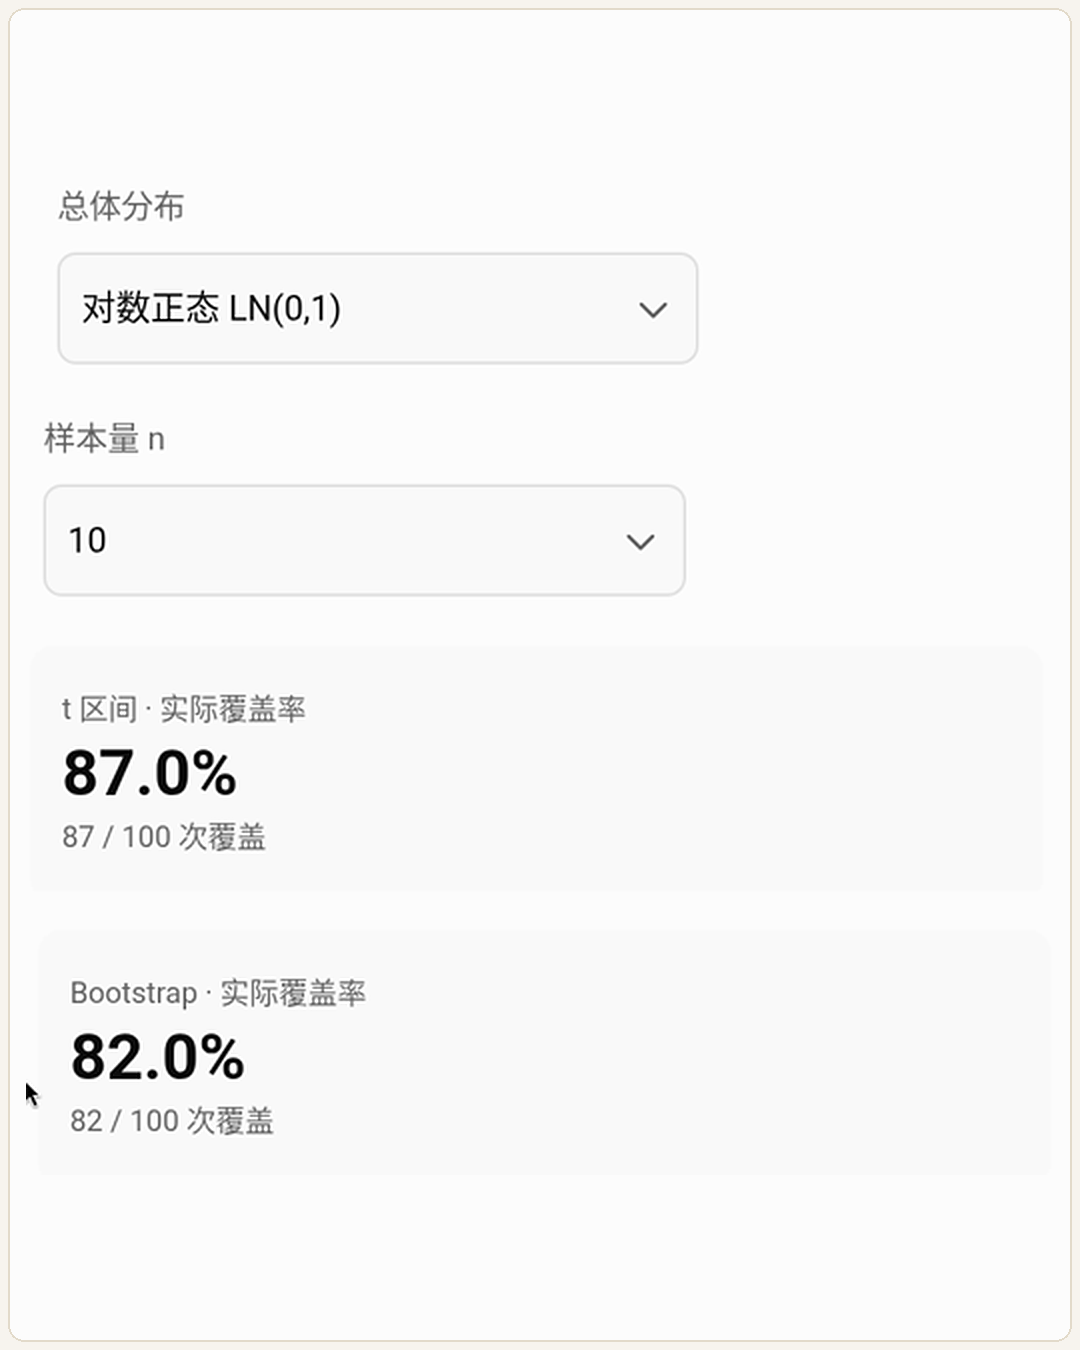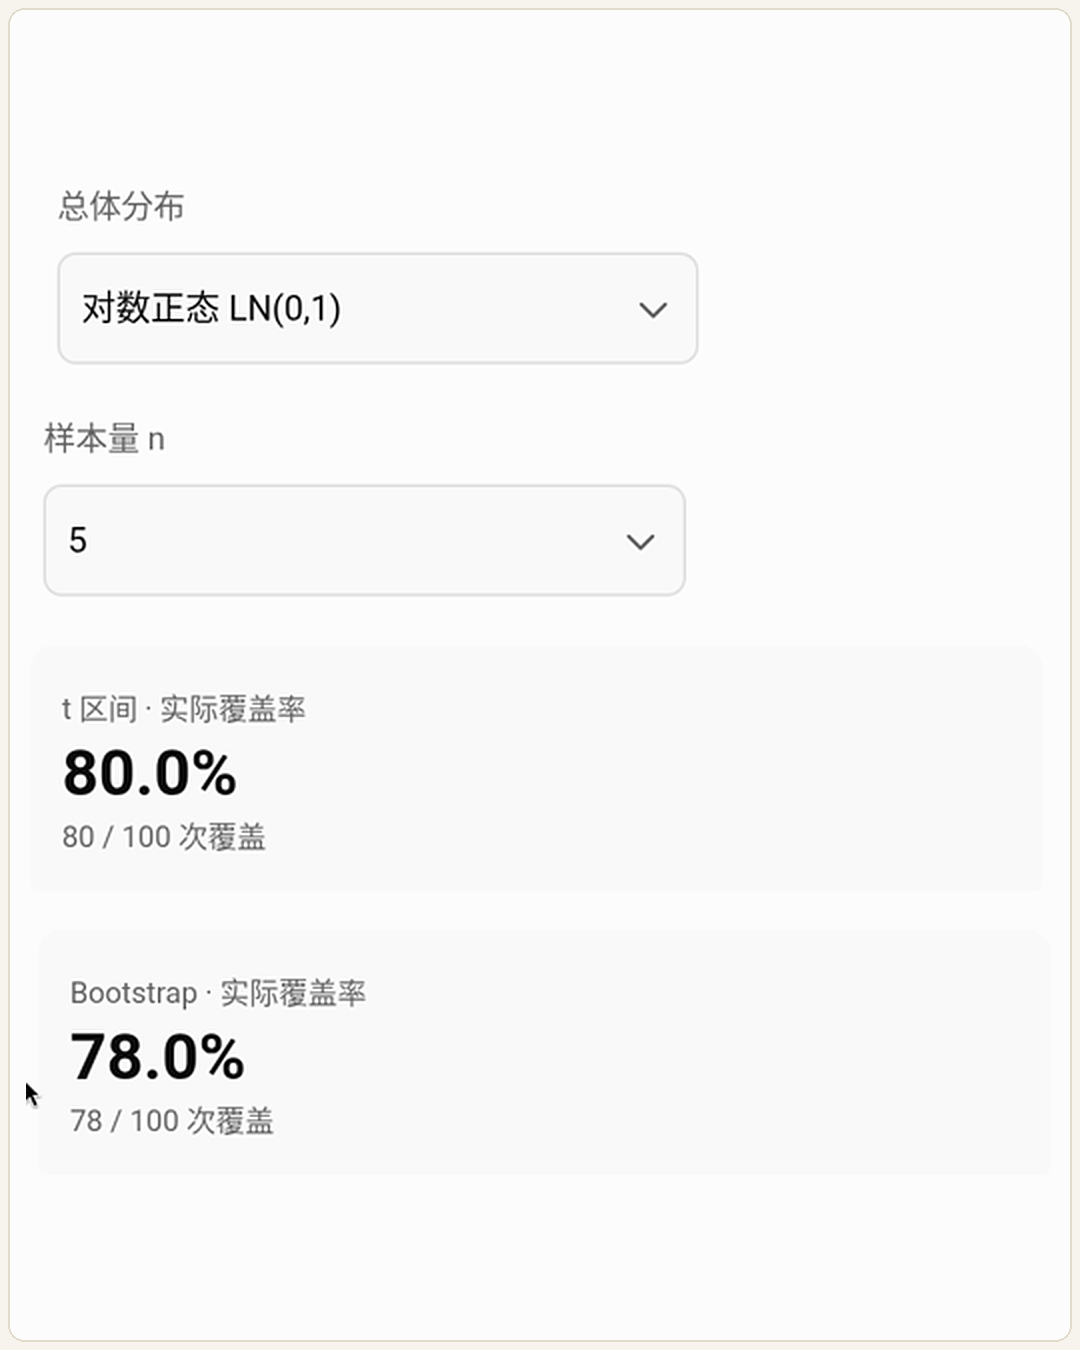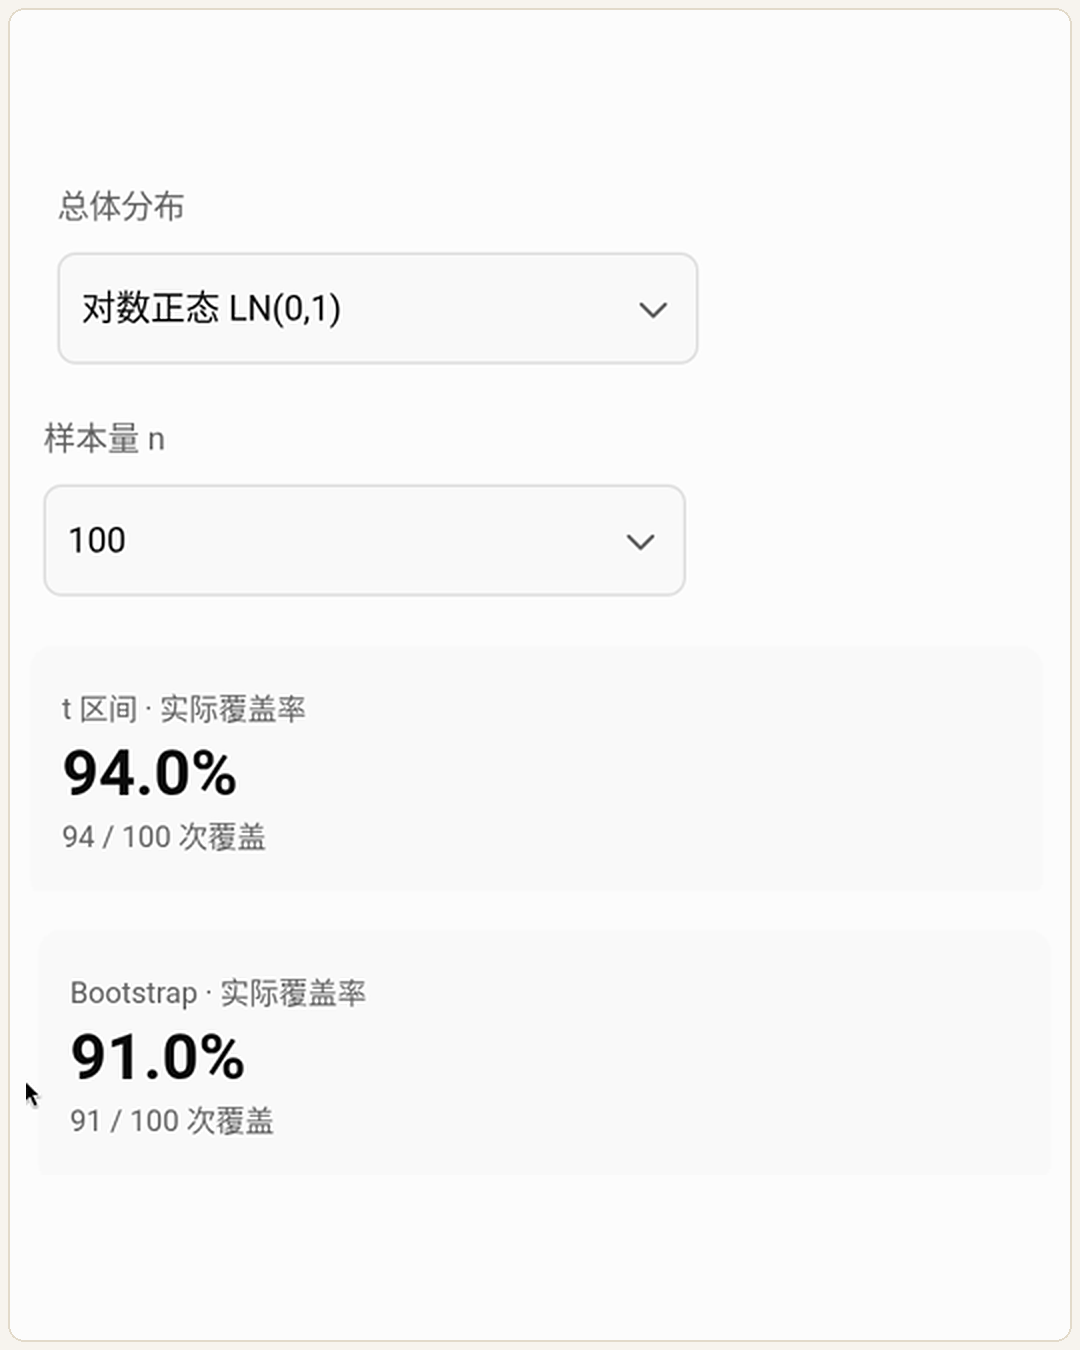
在模块里看,没盖住的红线一条条亮出来,比用嘴讲直观得多(为了手机上看得清,上面的动图只截了选项和读数)。
几组读数(每组都只是一批 100 条区间,有随机波动):
- 正态总体,n = 10:t 区间 96%,Bootstrap 91%
- 对数正态总体(很偏),n = 10:87% 和 82%
- 指数总体,n = 10:88% 和 84%
- 对数正态,n = 5:80% 和 78%
- 对数正态,n = 100:94% 和 91%
总体越偏、样本越小,区间越容易“盖不住”:同样是 n = 10,正态总体这批盖住了 96 条,很偏的对数正态只有 87 条;对数正态 n = 5 掉到 80 条,n 加到 100,这批升到 94 条(偏态总体下,长期大概也就九成出头)。不过每批只有 100 条区间,本身有随机波动(正态那批 96 条就比 95 还多一条;指数 88 条和对数正态 87 条差这一条也说明不了什么)。“95%”说的是:反复抽样时,长期约有 95% 的区间会盖住真值;想看稳定的覆盖率,要用它的“累计至 1,000 次”按钮多跑几轮。
另外,这五批里 Bootstrap 区间都比 t 区间低 2 到 5 个百分点。这是小样本下百分位 Bootstrap 区间偏窄的已知现象,不是模块算错。
第二个模块是 Beta-二项的贝叶斯更新:拖先验参数和观测数据,看先验、似然、后验三条曲线怎么移动。比如先验 Beta(2, 2),观测 7 次成功、3 次失败,频率估计是 70%,后验均值是 64.3%,被先验往中间拉了一点。
最有意思的是故意制造“先验与数据冲突”:先验极度乐观(Beta(32, 2),先验均值 94.1%),数据却是 27 次成功、119 次失败(成功率 18.5%)。后验均值落在 32.8%,既不像先验,也不像数据,三条曲线在图上分得清清楚楚。Beta(32, 2) 相当于“已经看过 34 次观测”,所以先验把后验拽得很厉害:后验区间 [26.1%, 39.8%] 和只看数据的 Wilson 区间 [13.0%, 25.6%] 完全不重叠。
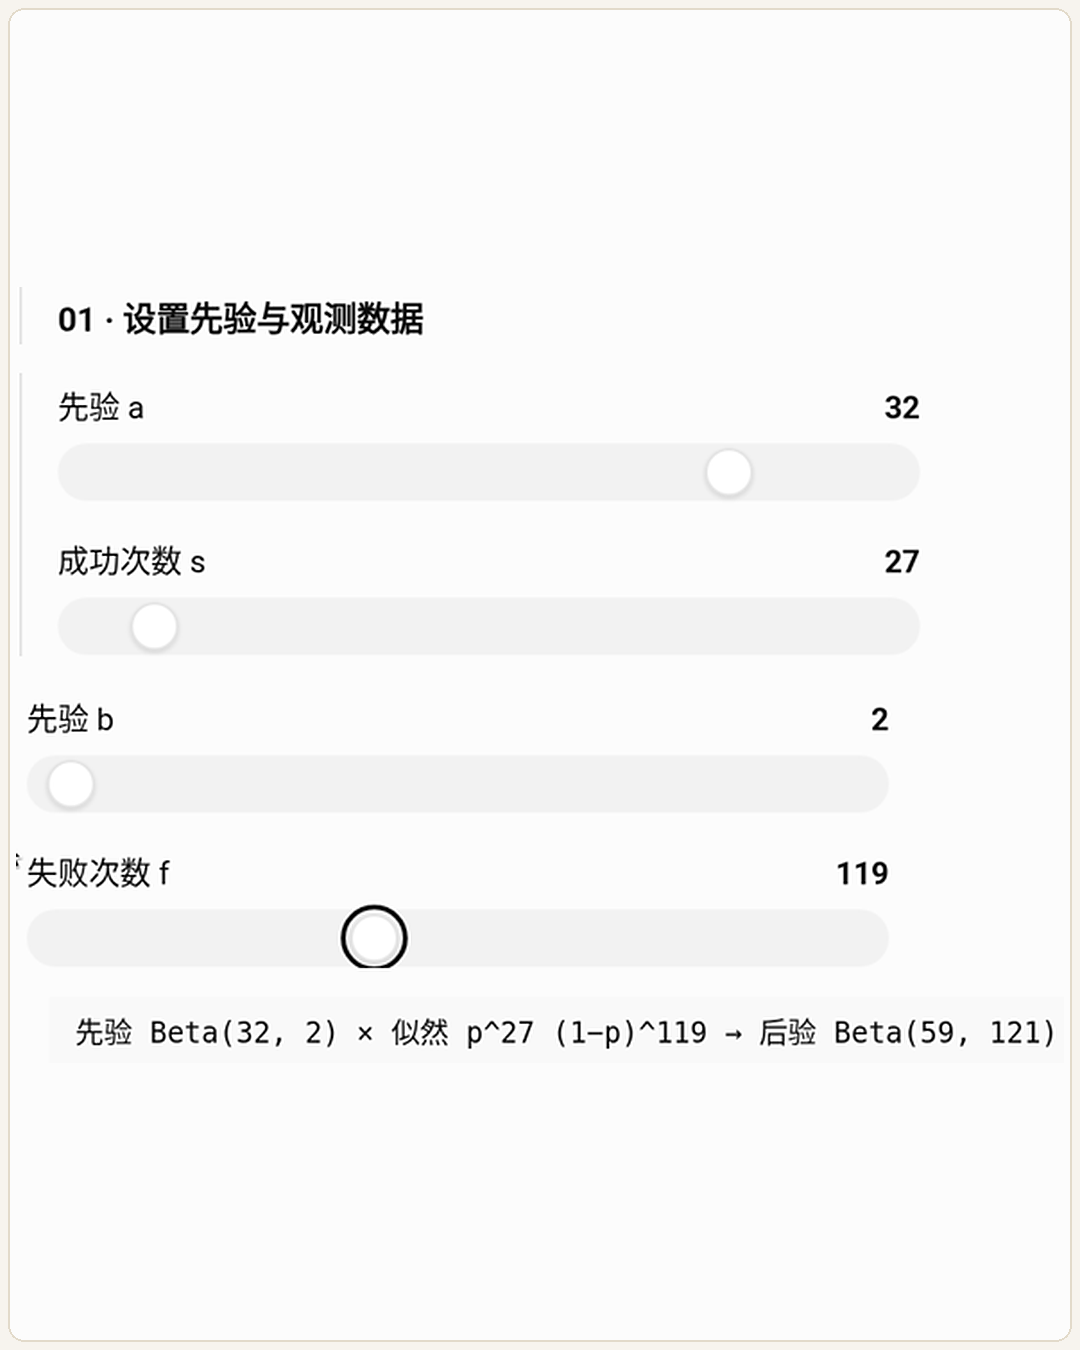
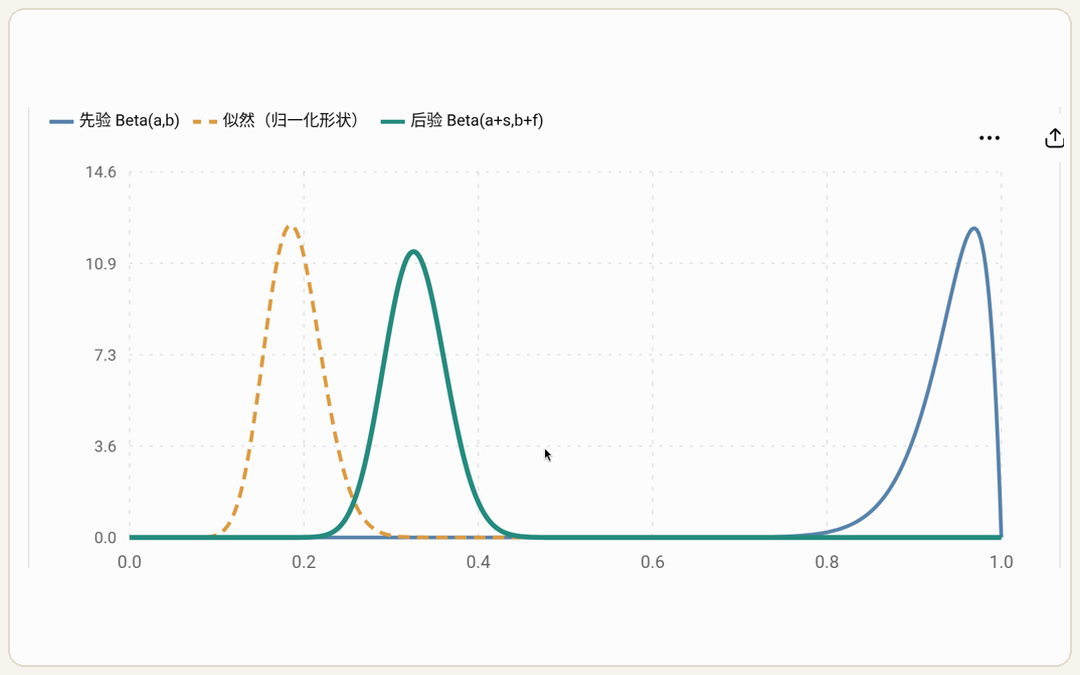
这几个后验均值我都按“(a + 成功数)/(a + b + 总次数)”验算过,比如 (32 + 27) / (32 + 2 + 146) = 59 / 180 ≈ 32.8%,没问题。
四、翻车现场:AI 做的模块也会算错
这次一共试了九个模块,有两处明显的 bug。
第一处,在 A 的抽奖实验里。规则是:花 5 元抽一次,20% 的概率得 20 元奖金。平均每次的收益(期望)是 0.2 × 20 − 5 = −1 元,长期平均每次亏 1 元,模块里的“理论期望 −¥1.00”也是对的。
可我一路点到抽满 1000 次,最显眼的“目前平均每次净收益”却是 +¥0.20,“累计净收益”是 +¥205.00。仔细一看:1000 次里中奖 205 次,累计收益正好等于中奖次数。看起来它每中一次只记了 +1 元,没中就记 0,大字显示的其实是中奖率(205 / 1000 ≈ 0.20),不是收益。
按规则(中奖净赚 15 元,不中亏 5 元)重算:1000 次应该是 205 × 15 − 795 × 5 = 3075 − 3975 = −900 元,平均每次 −0.90 元,和理论值 −1 很接近。有意思的是,同一个模块下方的折线图其实算对了,蓝线一路收敛到 −1 附近(鼠标停在第 336 次时显示 −0.802)。于是同一屏上,大字写着“在赚钱”,图上画着“在亏钱”。
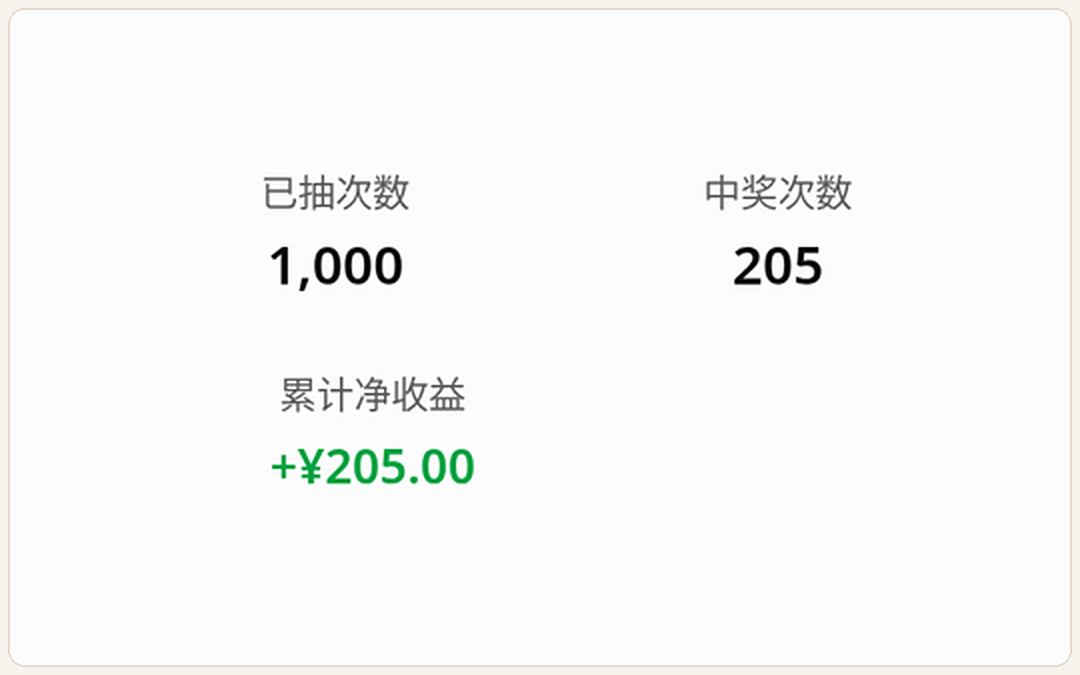
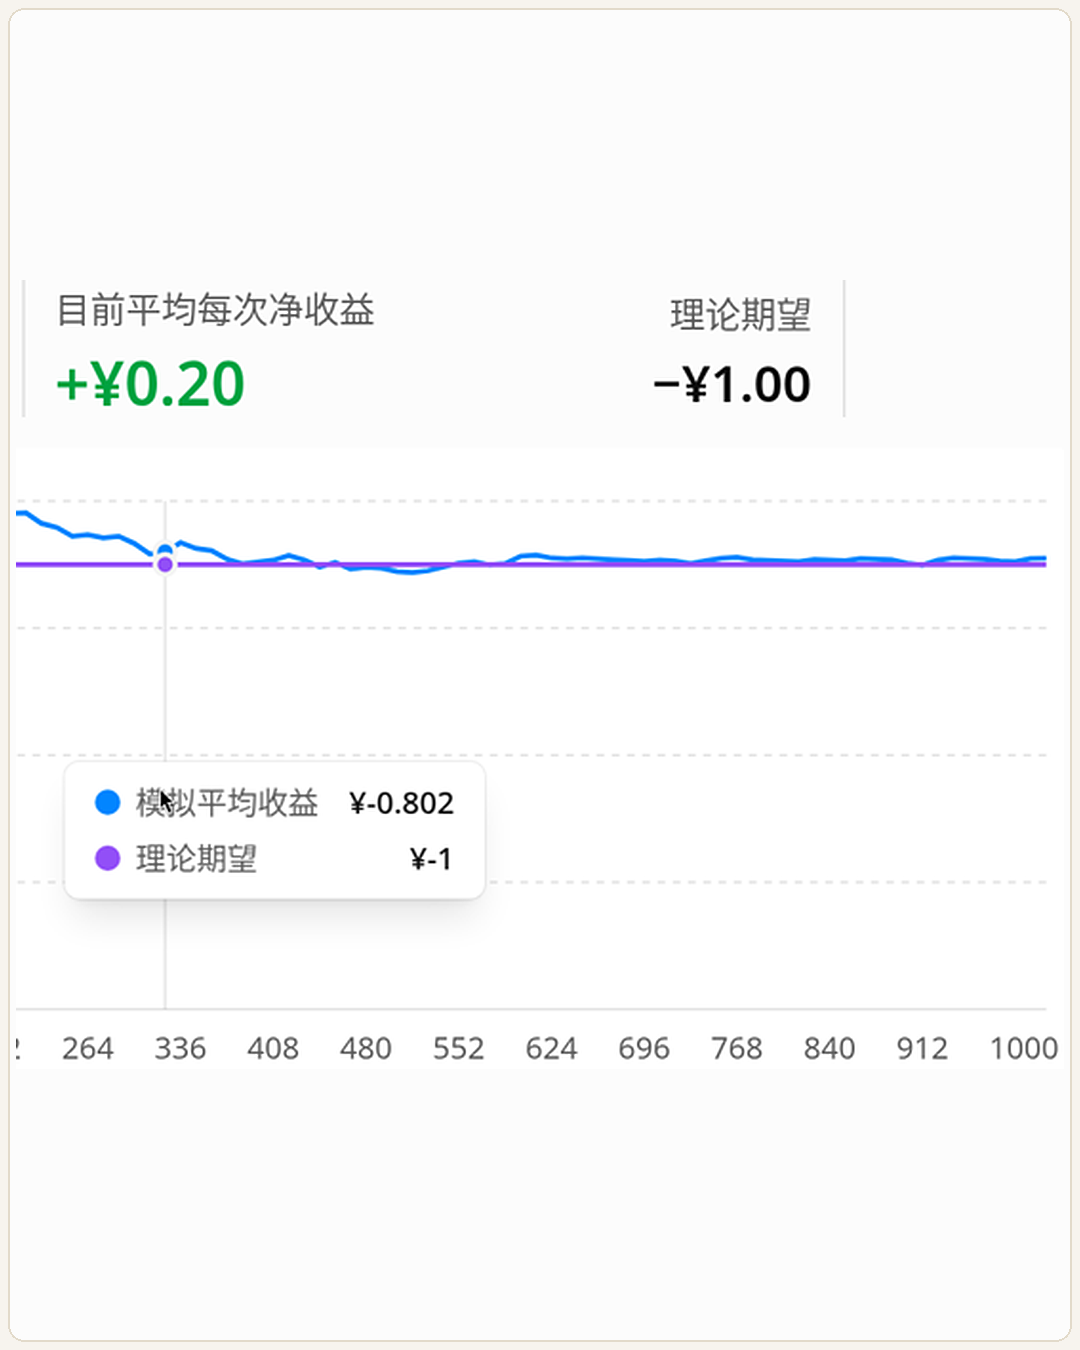
偏偏这个 bug 出在给零基础学生的模块里。初学者看到“理论 −1,模拟 +0.20”,很可能以为“理论和现实不一样”,学到的恰好是错的。
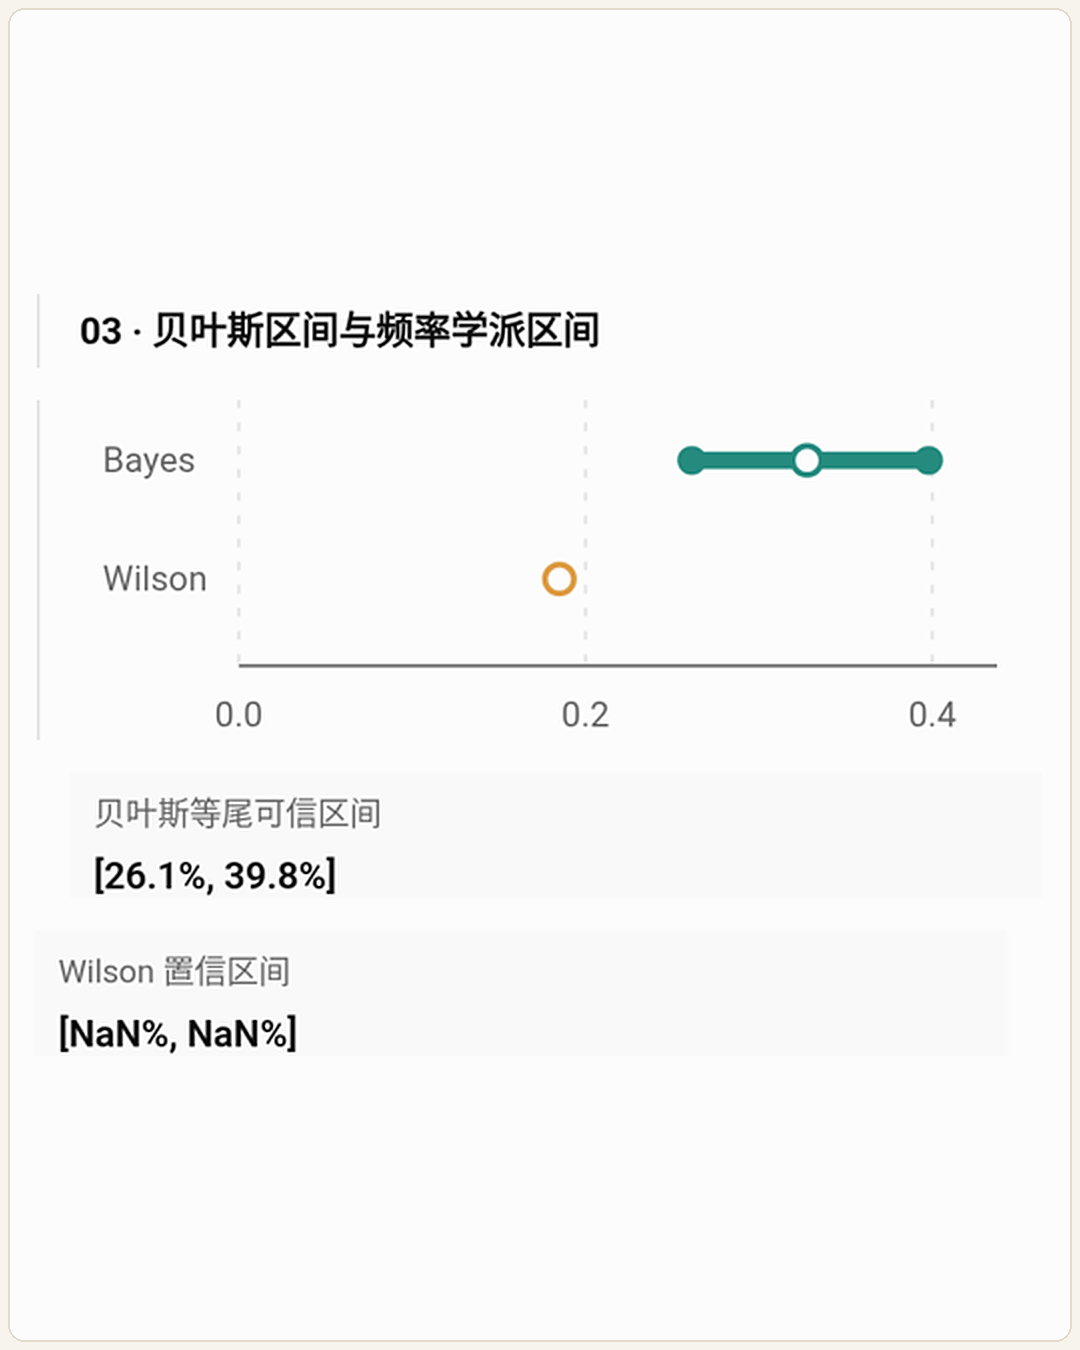
第二处,在 C 的贝叶斯模块里。它想把贝叶斯区间和频率派的 Wilson 区间放在一起对比,结果 Wilson 区间显示成了“[NaN%, NaN%]”(计算失败),旁边的贝叶斯区间 [26.1%, 39.8%] 倒是对的(我按 Beta(59, 121) 核对过)。按当时的数据(27 次成功、119 次失败)算,95% Wilson 区间应该约为 [13.0%, 25.6%]。
所以我的态度是:这些模块很好用,但不能当权威。它界面漂亮、讲解像模像样,算错了也不会提醒你。
五、怎么用好它:四个可以直接复制的提示词
我的经验是,提示词里写清三件事:我是谁(基础如何、目的是什么)、要哪些控件、要理论值和公式(方便核对)。下面四个可以直接改着用:
【零基础 · 条件概率】
我是经管专业大一学生,基础薄弱,害怕公式。请用疾病筛查的例子帮我理解条件概率。不要只用文字解释,请生成一个可以直接操作的交互模块:先让我猜答案,再用滑块调整患病率、灵敏度和特异度,用“一万人”示意图实时显示结果;最后给我 3 道由浅入深的小题。
【期末备考 · 先诊断再复习】
我是本科生,两周后考《概率论与数理统计》。请生成一个交互式诊断测验,覆盖随机变量及分布、数字特征、中心极限定理、参数估计、假设检验,共 10 题;答完后用图表显示各章掌握度、复习优先级,并给出 14 天复习计划。【参数估计 · 最大似然】
请为我生成一个“最大似然估计”交互实验:给出一组泊松分布的样本,用滑块调整参数 λ,同时画出似然函数和对数似然函数,标出最高点,并解释为什么最高点等于样本均值。请同时显示理论公式,方便我核对;最后给 2 道考试风格的练习题。【课堂演示 · 置信区间覆盖率】
我要给本科生上习题课。请生成一个置信区间覆盖率模拟器:可选正态、指数、对数正态总体,可调样本量和置信水平;一次画出 100 条区间,没盖住真值的标红;对比 t 区间和 Bootstrap 区间的实际覆盖率,并支持累计模拟 1000 次;最后给 3 个课堂追问题。还有三个小建议:
- 自己验算一两个数。挑极端情况试一试(比如概率拖到 0 或 1、样本量拖到最大),看结果合不合常理。
- 让它把理论值和模拟值并排显示。两者长期对不上,多半是模块写错了,而不是“理论失灵”。
- 适合课后自己摸索,也适合课堂演示(建议课前生成好,上课直接打开)。我没找到单独导出模块的入口,想分享给别人,目前只能试试发对话链接(我还没验证对方打开后模块能不能正常交互)。
老师是不是要失业了?
试完这一圈,我心里冒出过这个念头:同一个 AI,能按学生水平换三套讲法,还能当场生出可拖可点的实验室——个性化加上交互,教学的门槛好像一下子被抬高了。
但抬头想想,这篇文章里两个算错的 bug,正是最好的反例。模块界面漂亮、讲得像模像样,错了也不会举手。谁来挑出这些错、谁来设计整门课该讲什么、谁站在教室里接住学生当场的疑问、谁对评分和学术诚信负责——这些暂时还替不了。
所以我更愿意把它看成一个很强的教学助手:课前帮学生自学摸底,课上给老师多一件演示工具,课后让不同基础的人各自补缺。它能把“讲明白”这件事做得很细,但“教得对、教得稳、教得有人味”,还是老师的活。
写在最后
回到开头那个感觉:AI 已经不只是“回答问题”,而是开始“按你的情况搭一个小教室”了。零基础的人可以先玩出直觉,备考的人可以先找到短板,教课的人可以多一件演示工具。
但统计学教给我们的那条老规矩,在这里同样适用:别急着相信一个数,先看看它是怎么算出来的。
你最想让 AI 给你做一个什么样的概率统计“小玩具”?欢迎在留言区告诉我,下次我挑几个试试。