巴菲特效应:
同样是"买入",名人买入股价会多涨吗?
链接:https://arxiv.org/abs/2610.17231 | PDF
阅读状态:已通读全文 PDF(含正文与网络附录)。本页所有数字均摘自论文正文表格或附录表;凡是本页自行重算的结果标 本页重算,凡是用模拟数据画的图标 示意 · 模拟数据。
注意:这是尚未经同行评审的工作论文。
要点摘要
- 研究问题:同样是一次“新建仓”披露,由有名的基金经理披露,比由同类但无名的经理披露,股价会不会多涨一截?作者称这部分为“巴菲特效应”。(①)
- 设计:24 只知名主观选股基金,各用最优指派匹配 1 只无名对照基金,共 32,785 个新建仓与清仓事件(2000–2025);用事件研究 + 双重差分(买入/清仓 × 知名/对照)估计“披露溢价”。(②③)
- 发现:整体有溢价,而且不反转;效应集中在知名度 \(z \ge 1\) 的五位经理(巴菲特、伊坎、伯里、阿克曼、佩尔茨),全设定下“高知名度 − 对照”的 CAR[0,1] 为 +1.422%,CAR[0,5] 为 +2.309%。(④)
- 推断:高知名度效应只由 5 个处理单位识别;改用少聚类的野聚类自助法(WCR),CAR[0,30] 的 \(p\) 值从分析性的 0.016 变为 0.148——同一个系数,推断方法不同,结论可以不同。(⑤)
- 机制:高知名度买入披露后,散户交易笔数显著增加([0,1] +15.12 个对数点),单笔规模无显著变化,与“注意力”机制最一致。(⑥)
- 注意:这是尚未经同行评审的工作论文;主效应由 5 位经理驱动,有效样本很小。(⑦)
编者据本文正文整理;数字与结论详见下文各节。
① 背景:一个流传已久的"传说"
华尔街一直有个说法:伯克希尔·哈撒韦一披露买了什么,追随者就蜂拥而入,股价因为"巴菲特买了"而上涨。这到底是传说,还是可以被数据检验的规律?
美国规定大型机构投资者每季度通过 13F 表格向 SEC 披露持仓。13F 是公开的,所以任何人都能"抄作业"。已有研究发现,抄普通基金的作业在长期也能赚到超额收益。那么问题来了:
注意这个定义里藏着统计学最核心的概念:反事实。我们看不到"巴菲特买入但巴菲特不出名"的平行世界,只能找一个"其他方面相似、只是不出名"的对照组来近似它。整篇论文的设计都围绕着如何把这个对照做得可信。
作者提出了三种可能的机制,并分别推导出它们在数据中应留下的不同"指纹"——这是一个非常好的"用可证伪预测区分理论"的例子:
机制1:注意力(触达更多人)
信息相同,但名人的披露被更多人看到 \(\to\) 交易笔数增加;信息越稀缺的股票效应越大;不应反转。机制2:可信度(更有说服力)
每个看到的人更相信名人 \(\to\) 单笔交易规模变大,笔数未必变。机制3:盲目模仿(羊群)
与信息无关的跟风 \(\to\) 大盘股、小盘股都应出现;最关键:价格应该反转。统计启示
价格数据本身无法区分三种机制(三者都预测"涨")。需要引入额外的可观测结果(笔数、单笔规模、长期是否反转)才能识别。这正是"识别(identification)"的含义:找到一种数据,让不同的解释给出不同的预言。② 数据:从 215 个名字到 32,785 个事件
样本是怎样一步步筛出来的
"主观选股型"的硬性筛选标准:至少 12 期季度申报;最近一次申报在样本结束前 8 个季度内;平均每期多头持仓 \(\le 100\) 只;平均每季度"新建仓+清仓"事件 \(\le 20\) 个。被筛掉的例子包括 Renaissance(量化)、Citadel 与 Bridgewater(多策略/宏观)、BlackRock(资产管理)、Duquesne(已转为家族办公室)。
"知名度"怎么量化?—— 投资者知名度指数
作者用两个指标:经理维基百科页面 2015–2025 年的平均月浏览量,以及 ProQuest 新闻库 2000–2025 年的提及总次数。两者都严重右偏(巴菲特月浏览 323,969,最低的 Rosenwald 只有 437),所以先取自然对数,再在 24 只基金内标准化为 \(z\) 分数,最后取平均(再标准化为均值 0、标准差 1)。两个分量的相关:Spearman 0.832,Pearson 0.854。
红色:\(z \ge 1\) 的"高知名度"五人组(巴菲特、伊坎、伯里、阿克曼、佩尔茨)。切换到"原值"能直观看到为什么要取对数——巴菲特一根柱子把其余人压成了一条线。
右偏数据的对数变换与 \(z\) 分数标准化
大白话巴菲特的浏览量比最低的人高出好几个数量级。直接平均的话,巴菲特一个人就能把平均数拽走。取对数相当于只看"差了几个数量级":从 1 千到 1 万,和从 1 万到 10 万,算作同样大的一步。\(z\) 分数则像把不同科目的考试成绩都换算成"比全班平均高几个标准差",这样单位完全不同的两个指标才能放在一起比、一起加。
当变量跨越好几个数量级(437 到 323,969),直接平均会被极端值主导。取对数把"乘法差异"变成"加法差异"(\(\ln(ab) = \ln a + \ln b\)),再做 \(z\) 标准化 \(z_i = \tfrac{x_i - \bar{x}}{s}\) 让两个量纲完全不同的指标(浏览量、新闻条数)可以相加。
注意:\(z\) 分数是相对于这 24 人计算的(\(\bar{x}\)、\(s\) 都来自这 24 人)。"\(z \ge 1\)"的含义是"在这个样本里高于均值 1 个标准差",换一个样本,同一个人的 \(z\) 就会变。
Pearson 与 Spearman 相关
大白话两位评委给同一批选手打分,一位习惯打高分,一位习惯打低分。只要两人排出的名次差不多,Spearman 就高;Pearson 则更挑剔,要求分数大致落在一条直线上,而且一个特别离谱的分数就能把它带偏。
Pearson 衡量线性关系,对极端值敏感:\[r = \frac{\sum_i (x_i-\bar x)(y_i-\bar y)}{\sqrt{\sum_i (x_i-\bar x)^2}\,\sqrt{\sum_i (y_i-\bar y)^2}}\]Spearman 是对秩(排名)求 Pearson,\(\rho_s = r\big(\operatorname{rank}(x),\operatorname{rank}(y)\big)\),衡量单调关系,对极端值稳健。论文中两者都很高(0.854 / 0.832),说明"维基热度"和"新闻热度"给出的排名基本一致,合成指数的两个成分互相印证(一种聚合效度)。
对照组:找"不出名的双胞胎"
每只知名基金按组合规模、集中度、存续年限三项特征,用最优指派(optimal assignment)匹配一只从未进入维基名单的主观选股基金,使两组总距离最小。匹配后检验平衡性:
| 特征 | Welch \(t\) 检验 \(p\) 值(原始尺度) | 标准化均值差 SMD |
|---|---|---|
| 组合规模(SMD 按对数尺度) | 0.42 | \(+0.09\) |
| 集中度(每期持仓数;SMD 按对数尺度) | 0.55 | \(-0.11\) |
| 存续年限 | 0.12 | \(+0.46\) |
| 换手率(约 9 vs 7 次/季度;非匹配变量,样本外检查) | 0.91 | \(+0.03\) |
来源:附录表 IA.XI。组合规模与集中度的 SMD 在对数尺度上计算,Welch 检验在原始尺度上进行;换手率不是匹配变量,作为样本外检查报告。集中度中位数:知名组每期 19 只持仓,对照组 21 只。
匹配后的平衡性:为什么看 SMD 而不只看 \(p\) 值
大白话匹配就是给每位知名经理找一个"各方面条件相近的普通同行"。配得好不好,要看两组到底差多少(SMD,以标准差为单位),而不是看检验"显不显著"。每组只有二十几只基金时,检验就像一把刻度很粗的尺子:量不出差别,不代表两样东西一样长。
每组只有 24 只基金,样本量很小时 \(t\) 检验检验力很低,"不显著"不等于"平衡"。SMD 与样本量无关,常用经验阈值是 \(|\mathrm{SMD}| \lt 0.1\)(严格)或 \(\lt 0.25\)。按这个标准,存续年限的 \(\mathrm{SMD} = 0.46\) 其实不算平衡,尽管 \(p = 0.12\) "不显著"——论文自己也承认这是匹配最差的一项,并在回归中加入基金年龄等控制变量。
Welch \(t\) 检验不假设两组方差相等,是两独立样本均值比较的默认安全选择:\[t = \frac{\bar x_T - \bar x_C}{\sqrt{s_T^2/n_T + s_C^2/n_C}}\]
③ 方法:事件研究 + 双重差分
一次披露的时间线
事件研究法:异常收益 AR 与累计异常收益 CAR
大白话想知道"消息让股价多涨了多少",得先回答"没有这条消息时它本来会涨多少"。做法是:先用事件之前的数据,学会这只股票平时怎样跟着几股"大盘风向"一起涨跌;再用学到的关系预测事件期间的"正常收益"。实际收益减去这个预测,就是异常收益 AR;把几天的 AR 加起来,就是累计异常收益 CAR。下面是严格写法。
"异常"= 实际收益 − 模型预测的"正常"收益。\(\hat\beta\) 来自事件前的估计窗口,这是典型的样本外预测:如果用了事件窗口本身来估计 \(\beta\),事件效应会被模型"吸收"掉。
论文同时报告三种基准:Carhart 四因子(主结果)、市场调整(\(R_{it} - R_{m,t}\))、市场模型(单因子回归)。三者结果相近(见⑤),说明结论不依赖于"正常收益"模型的选择。
此外,所有 CAR 在 1% 和 99% 分位缩尾(winsorize):\(\tilde x_i = \min\{\max(x_i, q_{0.01}),\, q_{0.99}\}\),把极端值"压"到分位点上而非删除,以降低厚尾对均值的影响。
模拟(在你的浏览器里实时生成,不设随机种子:每点一次「重新模拟」就重新抽一整组随机数;拖动滑块只改设定的跳升,随机数保持不变,方便对比):200 只股票,日异常收益独立服从 \(\mathcal{N}(0,\,1\%^2)\),在第 0–2 天加入设定的跳升(每天 \(+\delta/3\))。浅色线是单只股票的 CAR,深色线是平均 CAR。请观察:单只股票的 CAR 几乎看不出信号,平均之后才浮现——这就是事件研究依赖"大样本平均 + 中心极限定理"的原因(平均 CAR 的标准差约为单只的 \(1/\sqrt{200}\))。拖动滑块把效应设为 0,看看纯噪声的平均 CAR 能漂多远。
核心估计量:双重差分(DiD)交互项
论文每张表报告的都是同一个系数,作者称之为"披露溢价"。
先说直观先别看公式,用一句话说:名人"买入比清仓多涨的那一截",再减去普通经理"买入比清仓多涨的那一截"。这就是"双重差分"(DiD):做两次减法。为什么要减两次,见知识点 5。
写成公式:
双重差分与交互项的解读
大白话两次减法,各去掉一种干扰。第一次在同一位经理身上减:"他买入后的反应"减"他清仓后的反应",去掉"他挑的股票本来就爱涨"。第二次在名人和普通人之间减:"名人的差值"减"普通经理的差值",去掉"谁披露都会引起的反应"。两次减法之后剩下的,才算在"出名"头上。
第一重差分"买入 − 清仓"在同一只基金内部做对比,消掉"这只基金的股票本来就爱涨"之类的基金特质;第二重差分"知名 − 对照"消掉"任何主观选股基金的披露都会引起的普遍反应"。剩下的 \(\beta\) 才是"知名度"的增量。
注意这里的 DiD 不是常见的"处理前/处理后 \(\times\) 处理组/对照组",而是"买入/清仓 \(\times\) 知名/无名"——DiD 的本质是交互项,两个维度可以是任何能各自消除一类混杂的对比。
逐步加控制变量(表 III 从第 1 列到第 6 列):如果系数随控制变量增加而基本稳定,说明可观测的混杂不太可能驱动结果——这是检验"遗漏变量偏误"敏感性的常用做法(但无法排除不可观测的混杂)。
聚类稳健标准误:真正的样本量是多少?
大白话好比做民调访问了近 3 万人,但这些人其实来自几十个村子,同村的人意见高度相似。真正独立的信息远没有 3 万份那么多,更接近"有多少个村子"。这里的"村子"就是基金经理。
表面上有近 3 万个事件,但同一位经理的多次披露彼此相关(相同的选股风格、相同的追随者)。标准误按经理聚类,聚类数 \(G = 48\)(高知名度对比时只有 29 个聚类,其中处理组仅 5 个)。
严格地说,聚类稳健方差是 \(\widehat{V}_{\text{CR}} = (X^\top X)^{-1}\Big(\sum_{g=1}^{G} X_g^\top \hat u_g \hat u_g^\top X_g\Big)(X^\top X)^{-1}\)。它的可靠性靠的是"聚类够多":渐近理论要求聚类数 \(G \to \infty\),而不是观测数 \(N \to \infty\)。处理组只有 5 个聚类时,这把尺子会"量短":常规聚类标准误往往低估不确定性,于是太容易拒绝原假设、宣称显著。这就是论文第⑤部分要用野聚类自助法的原因。
④ 发现:效应集中在"最有名的那几个人"
发现1:整体有溢价,而且不反转
知名组 vs 对照组(表 III)。未加控制的原始估计:CAR[0,1] +0.253%(\(p = 0.026\)),[0,3] +0.357%(\(p = 0.017\)),[0,5] +0.422%(\(p = 0.033\)),一直到 [0,20] 仍为 +0.780%(\(p = 0.049\));[0,30] 为 +0.490%(\(p = 0.320\)),不再显著但仍为正。加入全部控制和固定效应后,[0,1] 降到 +0.200%(\(p = 0.159\),不显著),但 [0,3] +0.341%(\(p = 0.043\))、[0,5] +0.499%(\(p = 0.031\))仍显著。披露前 [−10,−1] 为 −0.431%(\(p = 0.244\)),没有提前上涨。
值得注意的是这些回归的 \(R^2\) 只有 0.001–0.011:单个事件的收益几乎完全是噪声,但样本量大时系数仍可能被估计得足够精确——\(R^2\) 低 \(\neq\) 效应不存在。(也要注意"足够精确"并非处处成立:全设定下 [0,1] 的 \(p = 0.159\)。)
发现2:知名度梯度——不是线性,而是"拐点"
每个点是一只知名基金:横轴为知名度 \(z\)(表 I),纵轴为该基金新建仓事件的平均四因子 CAR(%,附录表 IA.III,未作对照组差分),点的大小 \(\propto\) 买入事件数。这对应论文图 2,但回归线是本页用 24 个点(Python/NumPy 计算)做的简单 OLS \(\overline{\mathrm{CAR}}_j = \beta_0 + \beta_1 z_j + e_j\),不等于论文表 IV 中带控制变量、按事件回归的系数(论文:每增加 1 个标准差知名度,CAR[0,1] +0.373%,\(p = 0.005\);CAR[0,5] +0.427%,\(p = 0.047\))。
论文把知名组按中位数一分为二,再按 \(z \ge 1\) 切出"高知名度"五人组(全设定,表 VI):
区间按论文计算 \(p\) 值的方式取 \(t_{G-1}\) 临界值:全部知名 − 对照 \(G = 48\),\(t_{47,0.975} = 2.01\);上半 − 对照 \(G = 36\),\(t_{35,0.975} = 2.03\);高知名度 − 对照 \(G = 29\),\(t_{28,0.975} = 2.05\)(例如 [0,30]:\(2.319/0.905 = 2.56\),\(t_{28}\) 给出 \(p = 0.016\),与论文一致,而正态近似会给出 0.010)。这仍是分析性区间,处理组只有 5 个聚类时可能偏窄,请对照第⑤节的 WCR \(p\) 值。
| 对比(全设定,%) | [0,1] | [0,3] | [0,5] | [0,10] | [0,20] | [0,30] | [−10,−1] |
|---|---|---|---|---|---|---|---|
| 全部知名 − 对照 | 0.200 | 0.341** | 0.499** | 0.684** | 0.772* | 0.435 | −0.431 |
| 上半 − 对照 | 0.485** | 0.691** | 0.869** | 1.022** | 1.056* | 0.983 | −0.183 |
| 下半 − 对照 | −0.054 | 0.033 | 0.182 | 0.377 | 0.525 | −0.052 | −0.672* |
| 高知名度 − 对照 | 1.422*** | 1.869*** | 2.309*** | 2.547*** | 3.091*** | 2.319** | 0.392 |
| 中等知名度 − 对照 | 0.088 | 0.201 | 0.331 | 0.504* | 0.544 | 0.252 | −0.530 |
| 高 − 中等 | 1.246*** | 1.456*** | 1.719** | 1.773** | 2.563** | 1.856** | 1.119 |
来源:论文表 VI。* \(p \lt .10\),** \(p \lt .05\),*** \(p \lt .01\)(分析性聚类稳健 \(p\) 值)。
拐点回归(表 VIII):在 \(z = 1\) 处加入一个"额外斜率"项 \(\max(z-1,\,0)\times\mathrm{buy}\)。基础斜率幅度较小([0,1] 每 SD +0.249%,\(p = 0.037\)),超过阈值后额外斜率 +0.827%(分析性 \(p = 0.014\)),[0,5] 额外斜率 +1.412%(\(p = 0.004\))。高知名度基金面对的总斜率约 +1.075%([0,1])。
但这个尾部项完全由 5 只基金识别,论文在表 VIII 中同时报告了少聚类野自助法 \(p\) 值:[0,1] 的 WCU \(p = 0.003\),WCR \(p = 0.133\)(仅"接近显著");[0,5] 的 WCR \(p = 0.032\);[0,30] 的分析性与 WCR \(p\) 都是 0.419。同一个系数,推断方法不同,结论就不同——这是第⑤节主题的又一个现成例证。
分段线性(拐点)回归与"阈值是怎么来的"
大白话拐点回归像阶梯电价:用电量超过某一档以后,每度电的单价变高,但电费总额是连续增加的,不会在档位上突然跳一下。这里"用电量"是知名度 \(z\),"档位"是 \(z = 1\),"单价"是斜率。
它允许关系在 \(c\) 处"转弯",但保持连续。
要警惕的是:阈值 \(c\) 是不是看了数据之后才选的?这就像"先开枪、后画靶":如果先看散点图,发现前五名特别高,再把阈值放在 \(z = 1\),那么常规 \(p\) 值会偏乐观。这叫数据窥探,也叫"分叉小径"。
论文表 XI 的阈值扫描(\(z \ge 0, 0.25, \ldots, 1.5\))展示了效应对阈值的敏感性,但不能消除数据窥探,原因有二:
- 如果事后已经看到前五名特别高,"阈值越高、效应越大"本来就是意料之中的模式;
- 这个"越高越大"只在 [0,1]、[0,3] 单调成立。[0,30] 的序列是 0.983 \(\to\) 1.664 \(\to\) 1.384 \(\to\) 2.319 \(\to\) 2.457 \(\to\) 3.401,并不单调。
能部分回应数据窥探的,是第⑤节的随机化推断:它把"哪 5 只被选中"当作随机。阈值是否事前设定,论文没有说明。
发现3:抄作业组合——一个月最强,之后衰减,但不反转
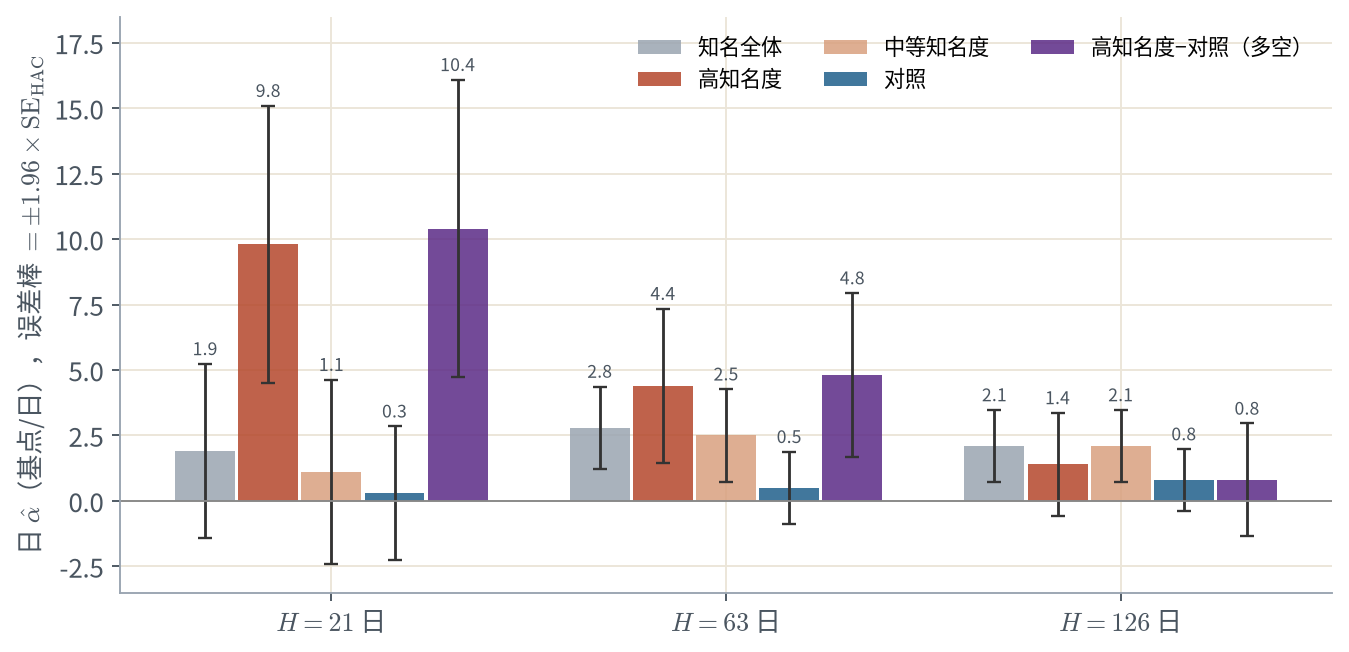
组合在申报后第一个交易日买入所披露的新建仓股票,持有 \(H\) 个交易日;等权、每日再平衡;回归标准误为 HAC(5 阶滞后)。高知名度组 \(H=21\):+9.8 bp/日(\(p \lt 0.001\)),\(H=63\):+4.4(\(p=0.003\)),\(H=126\):+1.4(\(p=0.164\));对照组在任何持有期都 \(\approx 0\)。多空(高知名度 − 对照)\(H=21\):+10.4 bp/日,论文按 \(\times 252\) 折算约 +26%/年。高知名度组的清仓组合 \(\alpha\) 为统计上零(\(p = 0.288\))。
日历时间组合、\(\alpha\) 与 HAC 标准误
大白话事件时间法把每次披露当成一份独立的答卷。可是很多披露挤在同一段时间,受同一阵市场风的影响,答卷之间相当于互相"抄"。日历时间法换个算法:每天把当时持有的股票装进一个篮子,只看这个篮子每天的收益,相关性就被装进篮子里了。\(\alpha\) 是篮子收益里几个因子都解释不了的那部分。
为什么还要做日历时间组合?事件时间法把发生在同一天的事件当作独立的,但 13F 申报集中在每季度截止日附近,多个事件的收益横截面相关,会低估标准误。把同一天的所有持仓合成一个组合,每天只有一个收益,横截面相关被"吸收进"组合收益里。
截距 \(\alpha\) 就是"因子解释不了的日均收益"。由于持仓重叠,\(\varepsilon_t\) 存在序列相关,所以用 Newey–West 型 HAC(异方差与自相关一致)标准误:\(\hat\Omega = \hat\Gamma_0 + \sum_{\ell=1}^{L}\big(1-\tfrac{\ell}{L+1}\big)(\hat\Gamma_\ell + \hat\Gamma_\ell^\top)\),论文取 \(L = 5\)。
年化的陷阱:\(10.4\ \text{bp} \times 252 \approx 26\%\) 是算术年化(复利年化应为 \((1+0.00104)^{252} - 1\)),还假设全年每天都有持仓、无交易成本;论文自己也指出组合平均只有约 10 只股票、只在申报季附近持仓、集中于小盘低流动性股票,实际可得收益会小得多。延迟一天建仓后,\(H=21\) 的 \(\alpha\) 降到 +4.9 bp/日(\(p = 0.064\)),\(H=63\) 为 +3.2(\(p = 0.029\))。
⑤ 稳健性:只有 5 个处理单位,如何还能做推断?
这是这篇论文最值得在统计课上讲的部分。高知名度效应完全由 5 位经理识别。只有 5 个"样本"时,常规公式算出的 \(p\) 值很可能过于乐观,所以作者换了四种角度反复检验,相当于四套"压力测试":
(a) 野聚类自助法(Wild Cluster Bootstrap)
| 高知名度 − 对照 | \(\hat\beta\) (%) | 分析性 \(p\) | WCR \(p\)(施加零假设) | WCU \(p\)(不施加) |
|---|---|---|---|---|
| CAR[0,1] | 1.422 | <0.001 | 0.011 | 0.002 |
| CAR[0,3] | 1.869 | <0.001 | 0.045 | 0.004 |
| CAR[0,5] | 2.309 | 0.002 | 0.071 | 0.001 |
| CAR[0,30] | 2.319 | 0.016 | 0.148 | 0.027 |
来源:表 IX Panel A。Webb 六点权重,\(B = 9{,}999\)。
野聚类自助法:WCR 与 WCU
大白话自助法的意思是"用手头的数据造出很多份平行数据,看估计值会怎样晃动"。"聚类"二字是说:每次给同一位经理的所有残差统一抽一个权重,像抛硬币或掷骰子决定乘以几,这样同一位经理的事件一起变,组内相关就保留下来了。WCR 造数据时先假定"效应为零",相当于站在怀疑者的立场检验结果;WCU 不做这个假定。
做法:保留解释变量不动,把每个聚类的残差整体乘以一个随机权重,\(y^{*}_{g} = X_g\tilde\beta + v_g^{*}\,\tilde u_g\)(Rademacher 取 \(v_g^{*} = \pm 1\);聚类很少时 \(\pm1\) 只有 \(2^G\) 种组合,所以用 Webb 六点分布 \(v_g^{*} \in \{\pm\sqrt{1/2}, \pm 1, \pm\sqrt{3/2}\}\)),生成"伪因变量"后重新估计,得到 \(t\) 统计量的自助分布。
- WCR(restricted):在生成伪数据时施加零假设 \(\beta=0\)(\(\tilde\beta, \tilde u\) 来自受约束回归)。少聚类时检验水平更准确,通常更保守。
- WCU(unrestricted):用无约束残差 \(\hat u\)。往往更"敢拒绝"。
请看上表:分析性 \(p\) 在 [0,30] 是 0.016,但 WCR 是 0.148——同一个系数,推断方法不同,结论可以从"显著"变成"不显著"。论文的表述是二者"夹住真相"。
(b) 随机化推断(置换检验):一共 42,504 种贴标签方式
在 24 只知名基金内部,"哪 5 只是高知名度"的标签共有 \(\binom{24}{5} = \tfrac{24!}{5!\,19!} = 42{,}504\) 种。如果"知名度与反应无关"(尖锐零假设:不管贴不贴"高知名度"标签,每只基金的反应都一样),这些标签就可以随意互换,统计上叫"可交换"。论文穷举全部标签,得到高 vs 中等知名度差异的置换 \(p \lt 0.01\)([0,1] 至 [0,20]),[0,30] 为 0.063。
大白话如果"出不出名"和股价反应毫无关系,那么谁被贴上"高知名度"标签就跟抽签一样。每点一次"洗牌",页面就从 24 位经理里随手抽 5 位当"高知名度"(金色),算一次差距 \(T\)。洗得越多,柱状图就越接近"纯靠运气能抽出多大差距"的全貌。红色柱是运气好到不输真实五人组(红框)的那几次,它们占的比例就是 \(p\) 值的估计。洗上几千次,估计值会慢慢靠近把 42,504 种抽法全部算一遍得到的精确答案(黑色阶梯线)。
下图是估计值随洗牌次数的变化:蓝线 \(b/B\),金色点线 \((b+1)/(B+1)\),黑色虚线是精确 \(p\),灰带是精确 \(p \pm 2\,\mathrm{SE}\)。B 很小时估计值常常冲出纵轴上沿,这正是"洗得太少不靠谱"。每次重置或换窗口都会清零重来,同样洗 1,000 次,每个人得到的估计会略有不同。
严格地说(蒙特卡洛置换检验):从全部 \(\binom{24}{5}\) 种标签中等概率、有放回地独立抽取 \(B\) 次,得到 \(T^{*}_1,\dots,T^{*}_B\),记 \(b=\sum_{i=1}^{B}\mathbf{1}\{T^{*}_i \ge T_{\text{obs}}\}\)。由于 \(b \sim \mathrm{Binomial}(B,\,p)\),其中 \(p\) 是穷举得到的精确置换 \(p\) 值,估计量 \(\hat p = b/B\) 是 \(p\) 的无偏估计,标准误为
以 [0,5] 窗口为例,\(p \approx 0.0010\):\(B = 1{,}000\) 时 \(\operatorname{SE} \approx 0.0010\),和 \(p\) 本身一样大;要把相对误差 \(\operatorname{SE}/p\) 压到 10%,需要 \(B \approx (1-p)/(0.1^2\,p) \approx 10^5\) 次。p 值越小,要洗的次数越多。这里能穷举,蒙特卡洛只是演示;组更大时(例如从 100 只里选 20 只,\(\binom{100}{20} \approx 5.4\times 10^{20}\) 种)无法穷举,只能抽样。
注:实务中常报告 \(\tilde p = (b+1)/(B+1)\),即把真实标签本身也算作一次"洗牌"。这样 \(\tilde p\) 永远不会等于 0(\(\hat p = 0\) 只说明洗得不够多,不说明 \(p=0\)),并且在零假设下 \(\Pr(\tilde p \le \alpha) \le \alpha\),检验水平有保证(Phipson & Smyth, 2010)。代价是略偏保守,\(B\) 很大时二者几乎相同。
统计量:\(T = \frac{1}{5}\sum_{j\in\mathcal{H}} \overline{\mathrm{CAR}}_j - \frac{1}{19}\sum_{j\notin\mathcal{H}} \overline{\mathrm{CAR}}_j\),即被标为"高知名度"的 5 只基金(集合 \(\mathcal H\))的平均 CAR 减去其余 19 只的平均 CAR(每只基金权重相同,使用附录表 IA.III 的基金均值,未做对照组差分与控制变量;精确分布由页面脚本现场穷举全部 42,504 种组合,结果与 Python itertools.combinations 的穷举逐窗口一致)。这是论文检验的简化教学版,\(p\) 值与论文不会完全一致;但思想完全相同。
置换检验 / 随机化推断
大白话置换检验就是"洗牌"。如果知名度与股价反应毫无关系,那"哪 5 位被贴上高知名度标签"就和随手抽签没有区别。把所有可能的抽签结果都试一遍,看真实那一组的差距排在多靠前。如果它排在最前面的极少数里,就说明光凭运气很难抽出这么大的差距。
\(p\) 值 = 在所有可能的标签分配中,统计量"至少和观测值一样极端"的比例:\(p = \tfrac{1}{42{,}504}\sum_{\pi} \mathbf{1}\{T_\pi \ge T_{\text{obs}}\}\)。它不依赖正态性或大样本,只依赖"零假设下标签可交换"。上式是单侧 \(p\);双侧版本把指示函数换成 \(\mathbf{1}\{|T_\pi| \ge |T_{\text{obs}}|\}\)。论文自己前后不一致:正文说读取"match or exceed"的比例(单侧),表 IX 注释却写"exact two-sided p"。本页图 6 两种都给出。
关键限制:可交换性必须合理。论文只在知名组内部置换,因为知名基金与对照基金来自不同的筛选流程,跨组置换并不满足可交换性。另一点:置换检验回答的是"这 24 只基金里,标签与反应是否相关",推广到其他基金需要额外假设。
(c) 留一刀切(Jackknife):是不是巴菲特一个人撑起来的?
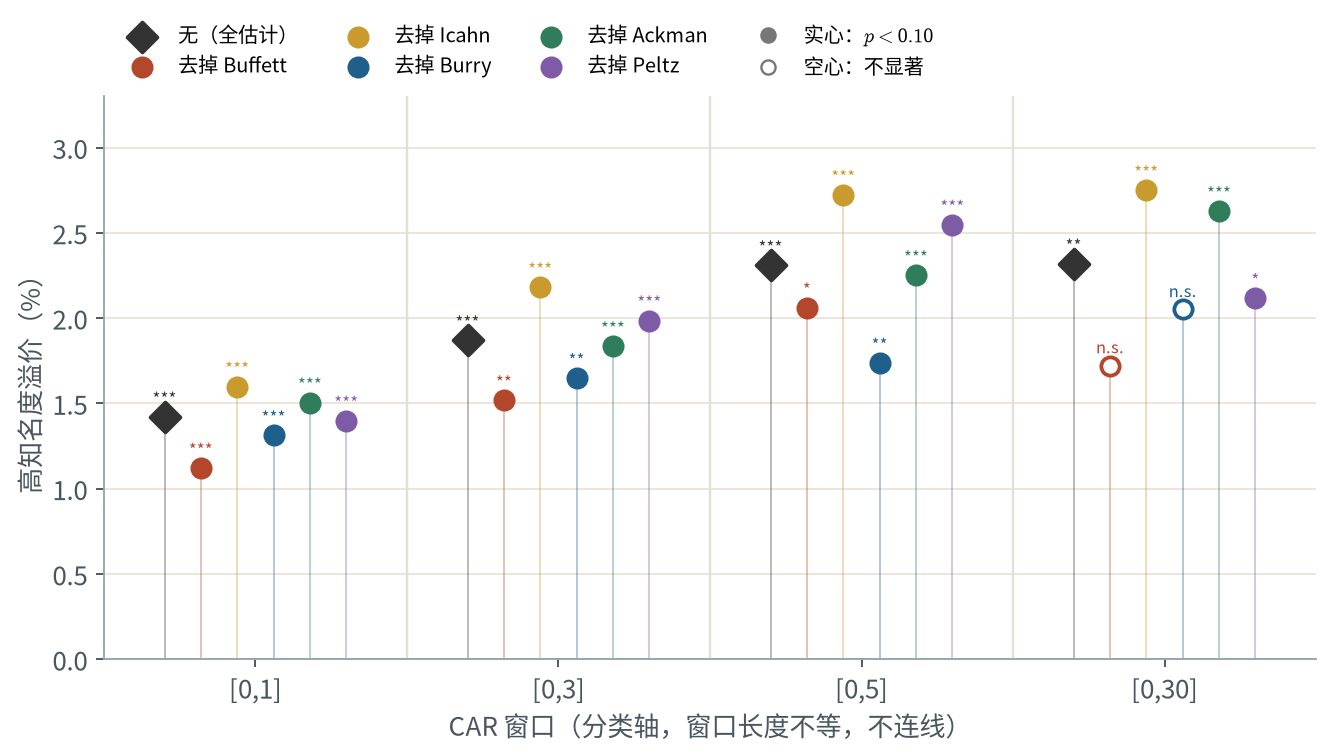
去掉巴菲特后 [0,1] 仍有 +1.122%(1% 水平显著);但去掉巴菲特或伯里后 [0,30] 不再显著。去掉伊坎反而让每个窗口的溢价都上升——附录表 IA.II 显示伊坎是五人中唯一自身没有正溢价的:[0,1] 为 +0.017%(\(p = 0.889\)),从 [0,3] 到 [0,30] 都显著为负([0,5] 为 −0.758%,\(p = 0.002\);[0,30] 为 −2.003%,\(p = 0.005\))。表 X 只给出显著性星号、没有标准误,所以图 7 用实心/空心和星号标出显著性,而不画区间。
刀切法与影响点
大白话刀切法就是"挨个请人离场":每次去掉一位经理,重算一遍,看结论变不变。如果去掉某一个人结论就塌了,说明结果主要靠他一个人撑着。
每次删掉一个观测单位(这里是一位经理)重新估计得 \(\hat\theta_{(-j)}\),看估计值波动多大,可用来发现强影响点并估计方差:\(\widehat{\mathrm{Var}}_{\text{jack}} = \frac{n-1}{n}\sum_{j=1}^{n}\big(\hat\theta_{(-j)} - \bar\theta_{(\cdot)}\big)^2\)。当总共只有 5 个处理单位时,每个单位都可能是"杠杆点"。回到图 3 勾选"去掉巴菲特",你会直观看到回归线斜率的变化。
(d) 其他检查
- 阈值扫描(表 XI):\(z\ge 0\)(12只)+0.485%;\(z\ge 0.5\)(7只)+0.601%;\(z\ge 1\)(5只)+1.422%;\(z\ge 1.25\)(3只)+1.493%;只有巴菲特(\(z\ge 1.5\))+1.865%(均为 [0,1])。\(z\ge 0.75\) 与 \(z\ge 1\) 恰好是同一组 5 只(第六名 Tepper 的 \(z\) 是 0.74)。
- 换异常收益模型(表 XI):[0,1] 四因子 1.422%、市场调整 1.505%、市场模型 1.476%。
- 剔除危机期(表 XII):同时去掉 2008–09 与 2020 后,[0,5] 从 2.31% 升至 2.76%,[0,20] 从 3.09% 升至 4.07%。
- 实时知名度(Ⅴ.B):静态指数用了全样本期信息(可能"用未来的名气给过去分组")。改用申报日之前才可得的维基浏览量滚动指数(2016年起),[0,1] 为 +1.52%(\(p = 0.004\)),略低于同子样本静态分类的 +1.77%。
- 控制过往选股能力(附录 IA.3):知名度与过往业绩相关(\(r = 0.47\),\(p = 0.02\));加入业绩控制后即时溢价仍在,但 [0,30] 在 8 种定义中有 6 种不显著。
前视偏差(look-ahead bias)
大白话好比用今天的球星名单去评价十年前的选秀:后来成为球星的人,当年也许并不出名。用"事后才有的名气"给过去的事件分组,就可能把"因为业绩好、后来才出名"误当成"因为出名、所以股价涨"。
如果分组变量用到了事件发生之后才知道的信息(编者举例:伯里的大众知名度很大程度上来自 2015 年电影《大空头》,而全样本静态指数会把他更早的披露也归入"高知名度"),就可能把"因为业绩好后来才出名"误读为"因为出名所以股价涨"。滚动指数是标准的修正办法。
⑥ 机制:更多人在交易,而不是每个人买得更多
用 2015–2025 年 NYSE 逐笔交易数据(TAQ),按 Boehmer 等(2021)的"亚美分(sub-penny)报价法"识别散户交易,比较高知名度买入披露 vs 对照买入披露后的交易行为(相对于 [−15,−6] 基线,单位:对数点 \(\times 100 \approx \%\),即 \(100\,[\ln y_{\text{事件窗}} - \ln y_{\text{基线}}]\))。
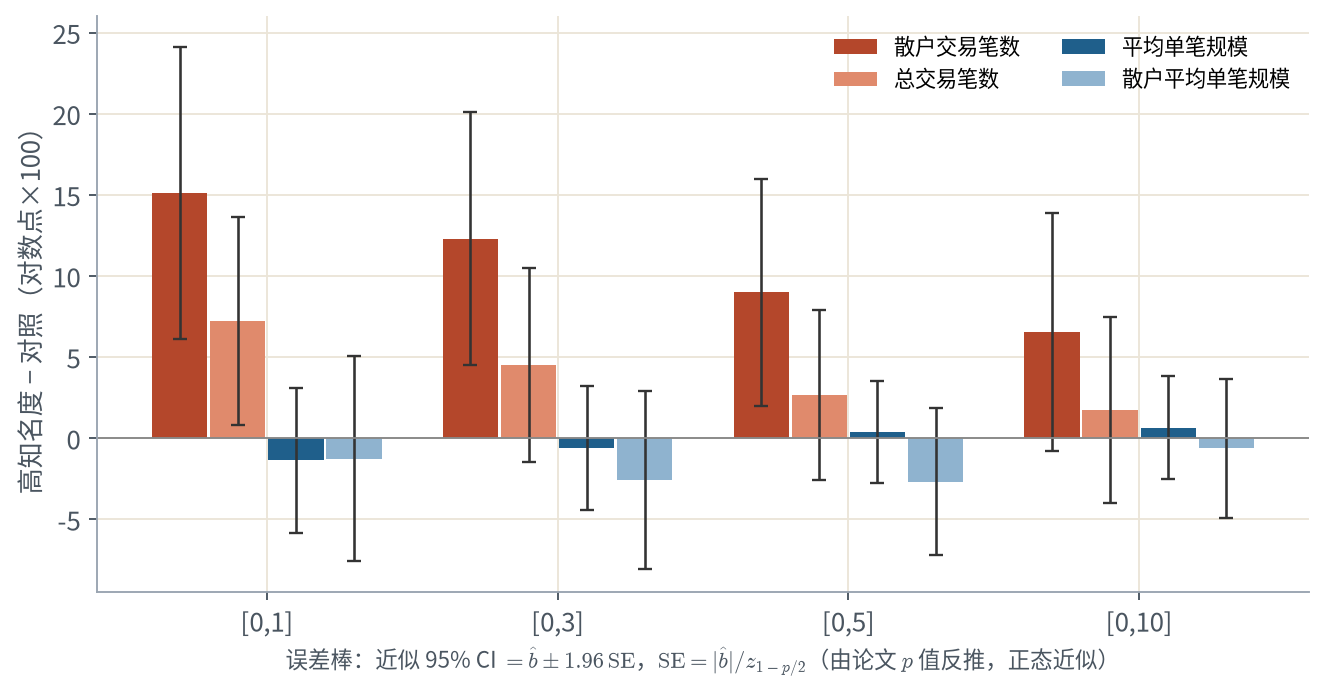
散户交易笔数:[0,1] +15.12(\(p = 0.001\)),[0,3] +12.30(\(p = 0.002\)),[0,5] +8.98(\(p = 0.012\)),[0,10] +6.55(\(p = 0.080\))。总笔数 [0,1] +7.24(\(p = 0.027\))。平均单笔规模:[0,1] −1.37(\(p = 0.547\)),[0,5] +0.38(\(p = 0.813\))——都不显著。论文提示该方法只能识别约三分之一的散户成交量,散户幅度应视为下界。
机制1 注意力
交易笔数显著增加;效应在小盘股([0,1] 2.21% vs 大盘 1.10%,差异 \(p = 0.009\))、低流动性股(2.09% vs 1.10%,\(p = 0.048\))更大。与数据最一致
机制2 可信度
单笔规模、\(\ge\)5万美元大单占比均无显著变化。未找到证据
机制3 盲目模仿
散户确实在跟单,但价格不反转(日历组合 \(\alpha\) 从未转负),且溢价集中于信息稀缺股票。不能完全解释
作者结论
"注意力—信息纠缠"渠道:知名度把稀缺的注意力引向特定披露,而披露中的信息随后被计入价格。"一个显著、一个不显著" \(\neq\) "两者差异显著"
大白话两个人参加考试,一个刚好过线,一个差一点没过。"一个及格、一个不及格"只说明两人落在线的两侧,并不说明两人水平差很多。两组结果谁大谁小,要直接检验它们的差。
表 XIV 的分组检验里就有现成的例子。机构持股 [0,30]:持股低的股票溢价 3.830%(\(p \lt 0.01\)),持股高的 1.903%(不显著)——"一个显著、一个不显著",但差异本身的 \(p = 0.778\)。市值 [0,10] 则反过来:小盘 2.934%(不显著),大盘 2.139%(\(p \lt 0.01\)),差异 \(p = 0.291\)。判断两组是否不同,必须直接检验差值 \(\hat\beta_1 - \hat\beta_2\),其标准误为 \(\mathrm{SE}(\hat\beta_1-\hat\beta_2)=\sqrt{\mathrm{SE}_1^2+\mathrm{SE}_2^2-2\,\mathrm{Cov}(\hat\beta_1,\hat\beta_2)}\),而不是比较两组各自的星号(Gelman & Stern, 2006)。这里 Cov 一般不为 0:两个子样本共享同一批经理聚类。
即使两组都显著也一样:机构持股 [0,10] 低持股 3.489%(\(p \lt 0.01\))、高持股 2.108%(\(p \lt 0.10\)),看上去差很多,差异 \(p = 0.617\)。
同理,交易数据的分组结果中,作者如实报告了唯一显著的差异是反方向的(覆盖面广的股票散户交易更多,\(p = 0.046\)),并把整体证据表述为"谨慎地支持机制1"。
"不显著"能否当作"没有"?
大白话在昏暗的房间里没看到钥匙,不能断定钥匙不在房间里,要先问灯够不够亮。这里的"灯"就是置信区间的宽度:只有区间够窄,而且整个落在"小到无关紧要"的范围里,才能说"没有效应"。
机制2的证据是一组"不显著"。不能拒绝原假设 \(\neq\) 接受原假设。更严格的论证应看置信区间是否足够窄、足以排除有经济意义的效应(等价检验 / TOST 思路:同时检验 \(H_{0}^{(1)}: \theta \le -\Delta\) 与 \(H_{0}^{(2)}: \theta \ge \Delta\),两者都拒绝才宣称 \(|\theta| \lt \Delta\))。用表 XIII 的点估计和 \(p\) 值反推标准误(\(\mathrm{SE} = |\hat b|/z_{1-p/2}\),正态近似),可以得到近似 95% CI(单位:对数点):
| 指标(窗口) | 点估计 | 近似 95% CI |
|---|---|---|
| 平均单笔规模 [0,1] | −1.37 | [−5.8, 3.1] |
| 散户单笔规模 [0,3] | −2.59 | [−8.1, 2.9] |
| 散户单笔规模 [0,5] | −2.68 | [−7.2, 1.8] |
| 对照:总交易笔数 [0,1] | 7.24 | [0.8, 13.7] |
规模效应的区间宽到排除不了与笔数效应同量级(约 5–7 个对数点)的规模变化,在任何合理的 \(\Delta\) 下 TOST 都通不过。所以正确的结论是:现有精度不足以排除经济上有意义的规模效应——"未找到证据" \(\neq\) "证据表明没有"。图 8 现在画出了这些区间,可以直接看到。论文本身没有做等价检验。
⑦ 局限:读论文时应当保留的怀疑
作者自己承认的
- 有效样本很小:主效应由 5 位经理驱动(高知名度组 815 次新建仓,对照组 7,940 次)。
- 样本是"精心策展"的:两组都依赖作者设定的筛选规则与人工核验;作者在附录中不做人工剔除重新匹配,结果不变,但换一套筛选规则可能得到不同样本。
- 交易数据无法区分"多少人买"与"每人买多少":需要账户级数据才能干净地区分注意力和可信度。
- 收益不等于可实现的策略收益:未扣交易成本,且集中在交易成本最高的小盘低流动性股票。
从统计角度值得追问的(本页编者提出,非论文观点)
- 多重比较:7 个窗口 \(\times\) 6 种设定 \(\times\) 多种对比 \(\times\) 多种分组,论文没有做多重检验校正。哪些结果是事先设定的主假设?
- 幸存者偏差:维基名单 2026 年 5 月获取,并要求基金"仍在活跃"——那些曾经出名、后来业绩崩溃而关门的经理不在样本里。
- 知名度是否外生?知名度与过往业绩相关(\(r = 0.47\))。"出名"可能只是"选股能力强"的代理变量;附录加入业绩控制后长窗口效应大多不显著。
- 个体基金的噪声很大:附录表 IA.III 中 Li Lu 只有 18 次买入,[0,30] 平均 CAR 为 −3.84%;Mudrick 只有 32 次。小样本基金的均值在图 3 中会显得"离群"。
- 13F 的信息可能已部分公开:大股东需通过 13D/13G 提前披露;作者在附录中剔除这部分后即时溢价仍在。
- 这是工作论文,尚未经过同行评审,数字可能在后续版本中变化。
⑧ 给学生的思考题
Q1(基础)为什么 CAR 要用"事件前"窗口估计因子载荷,而不能用包含事件日在内的全部数据?
提示:如果事件日的跳升进入了 \(\beta\) 的估计,"正常收益"会被抬高,异常收益被低估。思考这与机器学习中"训练集/测试集"分离的相似之处。
Q2(基础)用知识点 3 的公式解释:为什么 \(p = 0.12\) 的存续年限其实"不平衡"?如果样本量扩大到 240 对,同样的 \(\mathrm{SMD} = 0.46\) 对应的 \(p\) 值大约会怎样变化?
提示:每组 \(n\) 个单位时 \(t \approx \mathrm{SMD} \times \sqrt{n/2}\)。本例 \(n = 24\):\(t \approx 0.46\sqrt{12} \approx 1.59\),双侧 \(p \approx 0.12\),与论文完全吻合。\(n\) 扩大 10 倍,\(t\) 约扩大 \(\sqrt{10} \approx 3.16\) 倍,即 \(t \approx 5.0\),\(p\) 远小于 0.001——SMD 不变,"显著性"却完全变了。
Q3(DiD)写出"买入/清仓 \(\times\) 知名/对照"的 \(2\times 2\) 均值表,说明 \(\beta\) 等于哪四个格子的组合。如果某种市场情绪让"所有披露"的股票都上涨,它会被哪一重差分消掉?
提示:先差分"买入−清仓",再差分"知名−对照"。思考:如果名人的"清仓"本身也会引起特殊反应(例如股价下跌更多),\(\beta\) 会被如何影响?论文有现成证据可以权衡:表 XIII Panel B 显示,名人清仓后散户交易笔数同样显著增加([0,1] 为 +10.37,\(p = 0.010\)),说明"清仓"不是一个中性的基线;但高知名度组的清仓组合日历时间 \(\alpha\) 不显著(\(p = 0.288\)),又提示清仓没有带来明显的负向价格冲击。两方面合起来,\(\hat\beta\) 偏误的方向是什么?
Q4(推断)表 IX 中高知名度 vs 对照的 CAR[0,30]:分析性 \(p = 0.016\)、WCU \(p = 0.027\)、WCR \(p = 0.148\)。你会如何在论文中报告这个结果?为什么少聚类时 WCR 往往更可信?
提示:讨论第一类错误率、零假设下的残差构造、以及 Cameron, Gelbach & Miller (2008) 与 MacKinnon & Webb 的模拟结论。
Q5(动手)在图 6 中切换不同窗口,记录本页置换 \(p\) 值,与论文"[0,1]–[0,20] \(p \lt 0.01\),[0,30] \(p=0.063\)"比较。差异来自哪里?
提示:本页用的是未经对照组差分、未加控制、每只基金等权的基金均值;论文用的是全设定回归系数。再想想:组均值差的置换分布的中心为什么恒为 0(无论零假设是否成立)?——对所有 5/19 划分取平均,两组均值都等于总均值。零假设成立与否,影响的是"观测值能否看作这个分布中的一次典型抽样",而不是分布的中心;置换分布是以观测数据为条件构造的。
Q6(动手)在图 3 中勾选/取消"去掉巴菲特""去掉伊坎""按买入次数加权",观察斜率和 \(R^2\) 的变化。哪个点是高杠杆点?哪个点是大残差点?二者有何区别?
提示:杠杆 \(h_{jj} = \frac{1}{n} + \frac{(z_j-\bar z)^2}{\sum_k (z_k-\bar z)^2}\) 取决于 \(z\) 偏离均值的程度,巴菲特 \(z = 2.33\) 远离其他点;残差取决于 \(y\) 偏离回归线的程度。联系 Cook 距离 \(D_j = \frac{e_j^2}{k\,s^2}\cdot\frac{h_{jj}}{(1-h_{jj})^2}\)(\(k\) 为回归参数个数,这里 \(k = 2\))。
Q7(研究设计)如果你只想检验"机制3:盲目模仿",理想数据是什么?能否设计一个"自然实验"(例如某位经理突然因电影或新闻而出名)?
提示:知名度的外生冲击 + 前后对比 = 又一个 DiD。思考伯里与电影《大空头》(2015)的例子,以及其局限(同时期他的业绩信息也在传播)。
Q8(批判)论文报告了 7 个窗口、6 种设定、6 种对比。如果全部是独立检验且原假设都成立,在 10% 水平下大约会出现多少个"星号"?这对你阅读表 III–VII 有何启示?
提示:期望个数 = 检验数 \(\times 0.1\);但这些检验高度相关([0,3] 包含 [0,1]),所以"独立"假设不成立——讨论相关检验下的多重比较(Bonferroni 过于保守,可考虑 Holm、Romano–Wolf)。
Q9(延伸 · 中国市场)A 股没有 13F,但有"基金季报前十大重仓股"和"龙虎榜"。如何借鉴本文设计检验"明星基金经理效应"?对照组怎么找?知名度怎么量化?
提示:可用财经媒体提及次数、雪球/天天基金关注人数构造指数;注意季报公布时间集中、涨跌停限制对 CAR 的影响。