AI 订阅:一年留不住一半人,
谁在跟 ChatGPT 抢饭碗?
领域:平台与数字经济 / 产业组织 / 需求估计(JEL D12, L13, O33)。
阅读状态:已通读 NBER 版正文(§1–§8、图 1–9、表 1–5)与附录 A.1(商户识别)、B.1(估计细节)、C.1(付费决定因素回归)。数字摘自正文与表格;编者换算标 本页换算,模拟示意标 示意。
注意:NBER 工作论文未经同行评审;刷卡数据来自支付服务商 Fiserv,属专有数据,无法复现。论文披露两位作者与该公司有顾问关系,其中一位为付费顾问。
要点摘要
- 研究问题:ChatGPT、Claude、Gemini、Grok 之间,是“各有所长”、用户同时订好几家,还是越来越像、用户挑一家随时换?厂商不公开订阅数据,作者改看银行卡账单。(①)
- 数据:支付服务商 Fiserv 的匿名刷卡流水,1.74 亿名消费者,只保留当月至少 20 笔交易的人后为 8,200 万人;只看得到四家大厂的个人付费账户,免费用户和企业账户不在其中——样本大不等于样本对。(②)
- 描述性发现:至少为一家 AI 付费的消费者只有 2.9%;Claude 付费者中同时付费 ChatGPT 的比例从 44% 降到 28%,多归属指数(对数优势比)从 5.2 降到 2.9;OpenAI 新付费者一年后仍在付费的约 45%,Netflix、Spotify 约 70%。(③④⑤)
- 结构模型:随机系数 Logit 加模拟极大似然,区分“互补”与“相关偏好”:ChatGPT 与 Claude 的偏好相关系数 0.889,组合项一直为负且越来越强——高多归属主要来自相关偏好,而不是互补。(⑦)
- 价格与福利:价格系数靠 xAI 一次涨价作工具变量识别(IV −0.222,OLS −0.179),平均自价格弹性 −4.6;OpenAI 静态勒纳指数 59%;反事实中移除份额 0.5% 的 Anthropic,每位 AI 用户每季度福利损失 5.05 美元。(⑧⑨⑩)
- 注意:NBER 工作论文未经同行评审;刷卡数据属专有数据,无法复现;价格效应只由一次涨价识别,反事实是模型内计算,没有置信区间。(⑪)
编者据本文正文整理;数字与结论详见下文各节。
① 悬念:大模型之间,是“各有所长”还是“随便换”?
如果 ChatGPT、Claude、Gemini、Grok 各有绝活,用户会同时订好几家,厂商各守一块地盘,价格好定;如果它们越来越像,用户就会挑一家、随时换,价格战一触即发。这关系到 AI 行业将来是“一家独大”还是“几家缠斗”。
问题是,厂商不公开订阅数据。四位作者换了个角度:看银行卡账单。每月扣给 OpenAI、Anthropic、Google、xAI 的那 20 美元左右,都留在了支付流水里。
数字来自论文摘要与正文第 1、3、6、7 节。
② 刷卡数据:很大,但不是“全体美国人”
数据来自支付服务商 Fiserv 的匿名信用卡、借记卡交易:2021 年 1 月到 2026 年 4 月,1,140 亿笔交易、7.19 亿张卡、1.74 亿名消费者。为了尽量只看“主力卡”,作者只保留当月至少 20 笔交易的人,样本降到 8,200 万人。2026 年 1 月,样本里的人平均每月刷 63 笔、花 3,268 美元;46% 在 55 岁及以上。
AI 付费靠商户名识别,只看四家大厂的个人付费账户;免费用户、公司统一采购的企业账户都看不到。
抽样框与覆盖偏差:样本大 ≠ 样本对
本科大白话在健身房门口问“你每周锻炼几次”,问一万人也估不准全国平均,因为你只问到了会来健身房的人。抽样框偏了,偏差不会因为样本变大而消失。
这篇论文的抽样框是“经 Fiserv 处理的卡、且当月刷卡 ≥20 笔的人”。至少有三处覆盖问题:不用卡或很少刷卡的人被排除;用企业账户付费的看不到;只看付费、不看免费使用。作者也强调这个口径有意比问卷窄:问卷里“用过生成式 AI”的美国成年人约一半,这里“为 AI 付费”的只有 2.9%。两个数不矛盾,它们量的不是同一件事。
读大数据研究,先问三件事:谁有机会进样本?筛选条件会把谁筛掉?结果变量量的是“用”还是“付钱”?
③ 谁在付费:年轻、高收入、住在大学城
2026 年 4 月,2.9% 的消费者至少为一家 AI 付费,OpenAI 占大头(2.4%)。按美国持卡人数放大,超过 600 万人,约等于《华尔街日报》和《经济学人》订户之和。Anthropic 增长最快:2026 年 2 月 Claude 4.6 发布后,1 月到 4 月付费人数翻了三倍。
年收入 20 万美元以上的人,付费概率是 5 万美元以下的 1.7 倍;55 岁以下约 3.5% 付费,55 岁及以上 1.9%。大学学历比例最高的四分之一邮编区付费率 4.3%,最低四分之一不到 2%。哈佛商学院所在的邮编 02163 高达 38%。
生态谬误:地区的相关 ≠ 个人的相关
本科大白话“大学生多的小区订 AI 的人多”,不等于“大学生更爱订 AI”。也许这些小区收入高、离科技公司近,订 AI 的恰好是住在那里的工程师。
论文里的年龄、收入是按个人归入的分组;学历、族裔则是邮编层面的比例。用地区汇总变量与行为的关系去推断个人层面的关系,就是生态谬误(ecological fallacy)。正确读法是“高学历邮编区付费率更高”,而不是“高学历的人付费率更高”。
顺带一个大样本陷阱:论文附录用多元回归看谁更可能付费,对 7 个产品(Anthropic、Google、OpenAI、xAI,以及 Midjourney、QuillBot、Cursor)各做一个回归,因变量是该产品的付费人数比例(百分点)。每个回归都有 2,100 多万个观测(每个观测是“邮编×年龄组×收入组×月”单元格,按人数加权),绝大多数系数都在 1% 水平显著,可组内 \(R^2\) 最高的 OpenAI 也只有 0.11,Anthropic 0.026,Google、xAI 只有 0.002–0.003。显著说明“不是零”,不说明“解释力大”。
④ 多归属:同时订两家的人在减少
“多归属”(multihoming)指同一个人同时用多个竞争平台,比如手机里同时装两个打车软件。2024 年 6 月,Claude 付费者里有 44% 同时付费 ChatGPT;到 2026 年 4 月降到 28%。反过来,ChatGPT 付费者里同时付费 Claude 的,到样本末期接近 6%。
但“44% 很高”是相对什么而言?Claude 的付费者多是重度用户,重度用户本来就更可能订 ChatGPT。作者用一个不受各自普及率影响的指标来回答。
2×2 表与对数优势比:两件事是否“结伴出现”
本科大白话把所有人按“订不订 ChatGPT × 订不订 Claude”分进四个格子。若两件事毫无关系,“都订”与“都不订”的乘积,应正好等于“只订甲”与“只订乙”的乘积。前者是后者的多少倍,就是结伴的程度。
这就是 2×2 表的对数优势比(log odds ratio),O、A 分别指 OpenAI、Anthropic。若订两家相互独立,分子分母都等于 \(p_O p_A(1-p_O)(1-p_A)\),指数为 0。优势比的好处是不随两家各自的普及率变化,所以能跨时间、跨产品对比较。
OpenAI–Anthropic 这一对的指数从 2024 年 6 月的 5.2 降到 2026 年 4 月的 2.9;正文换算为优势比约从 181 降到 18(\(e^{5.2}\approx181\),\(e^{2.9}\approx18\))。仍远大于 1,两家仍然“结伴”;但结伴程度降了一个数量级。
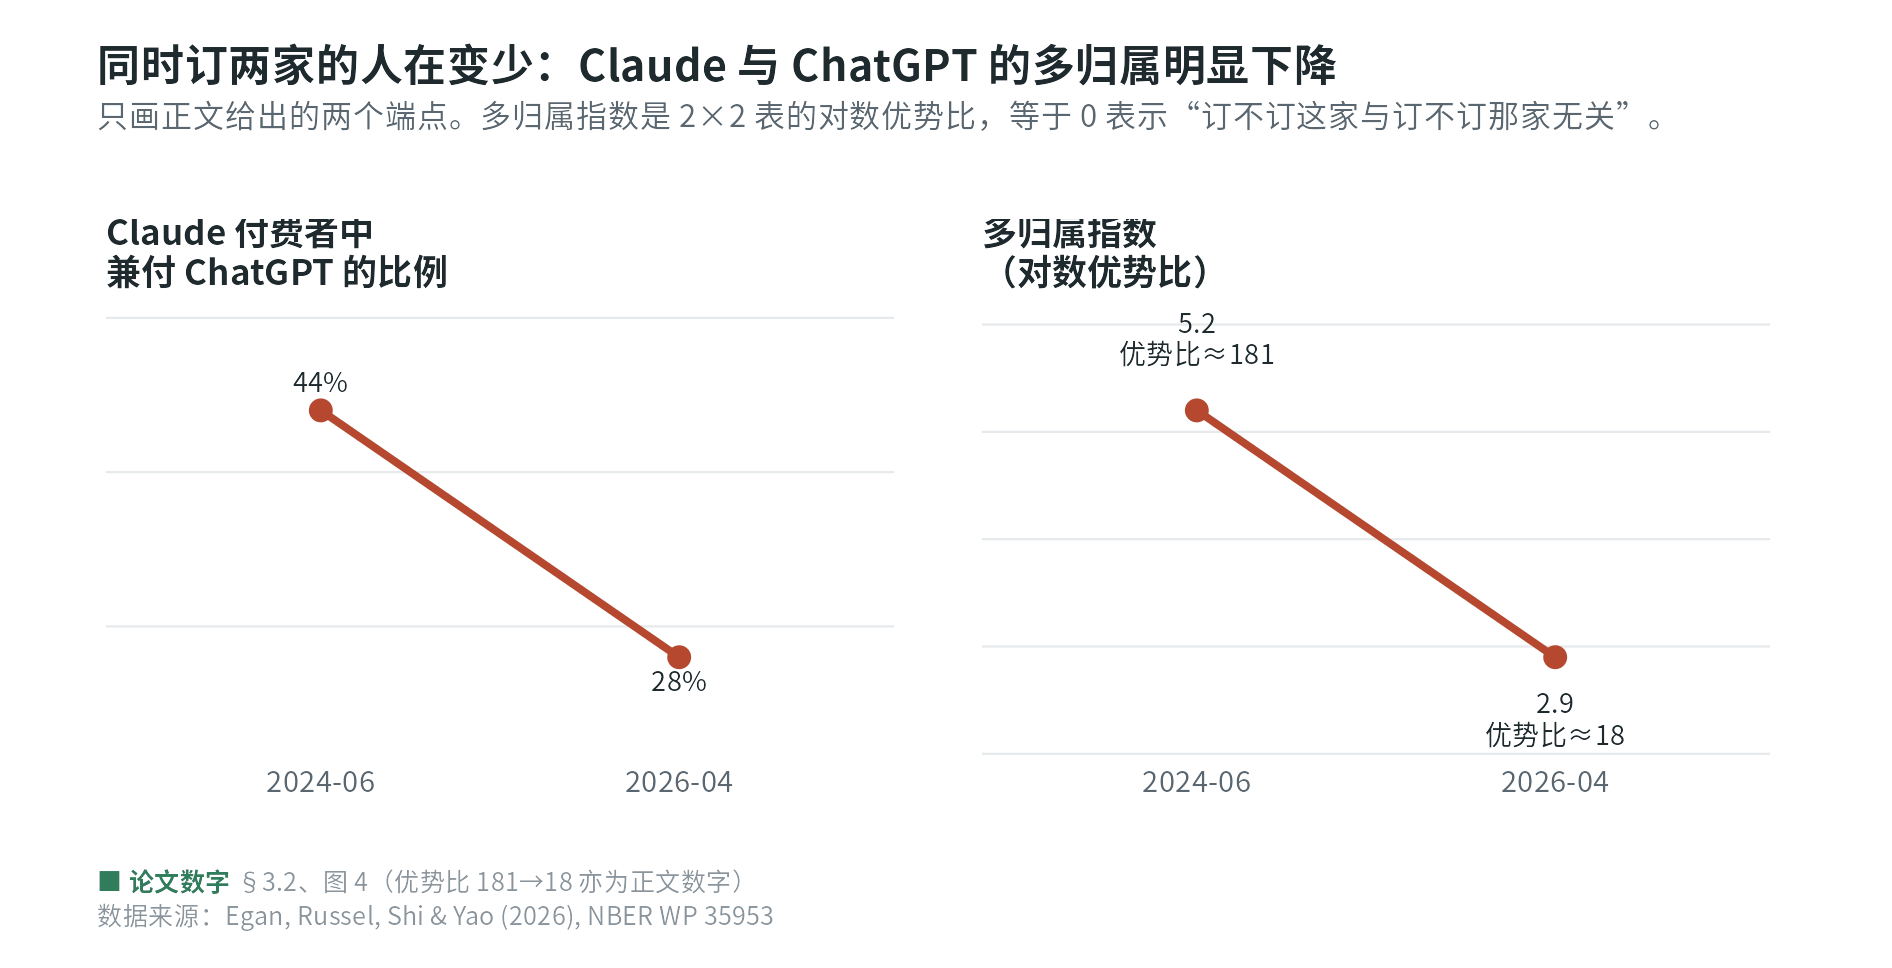
论文数字 图 1 多归属的两个口径。左:Claude 付费者中同时付费 ChatGPT 的比例;右:多归属指数(对数优势比)。只画正文给出的起止两点。论文正文说明,这一指数在样本期内随时间下降;其他产品组合也有类似但较缓的下降。
作者的解读:大模型越来越“通用”,Claude 也能写稿、ChatGPT 也能写代码,用户就不必两家都订。这正是“替代品”的样子。
⑤ 留存:AI 订阅比视频会员难留
从第一次付费算起,OpenAI 一个月后还剩 77%,三个月 65%,六个月 55%,一年约 45%。Anthropic 和 xAI 更低且彼此相近:约 65%、50%、40%;Anthropic 一年约 30%。Google 最低。对比同一数据里的非 AI 订阅:Spotify、Netflix 三个月留存在 80% 以上,一年约 70%;《纽约时报》三个月也有 70%。
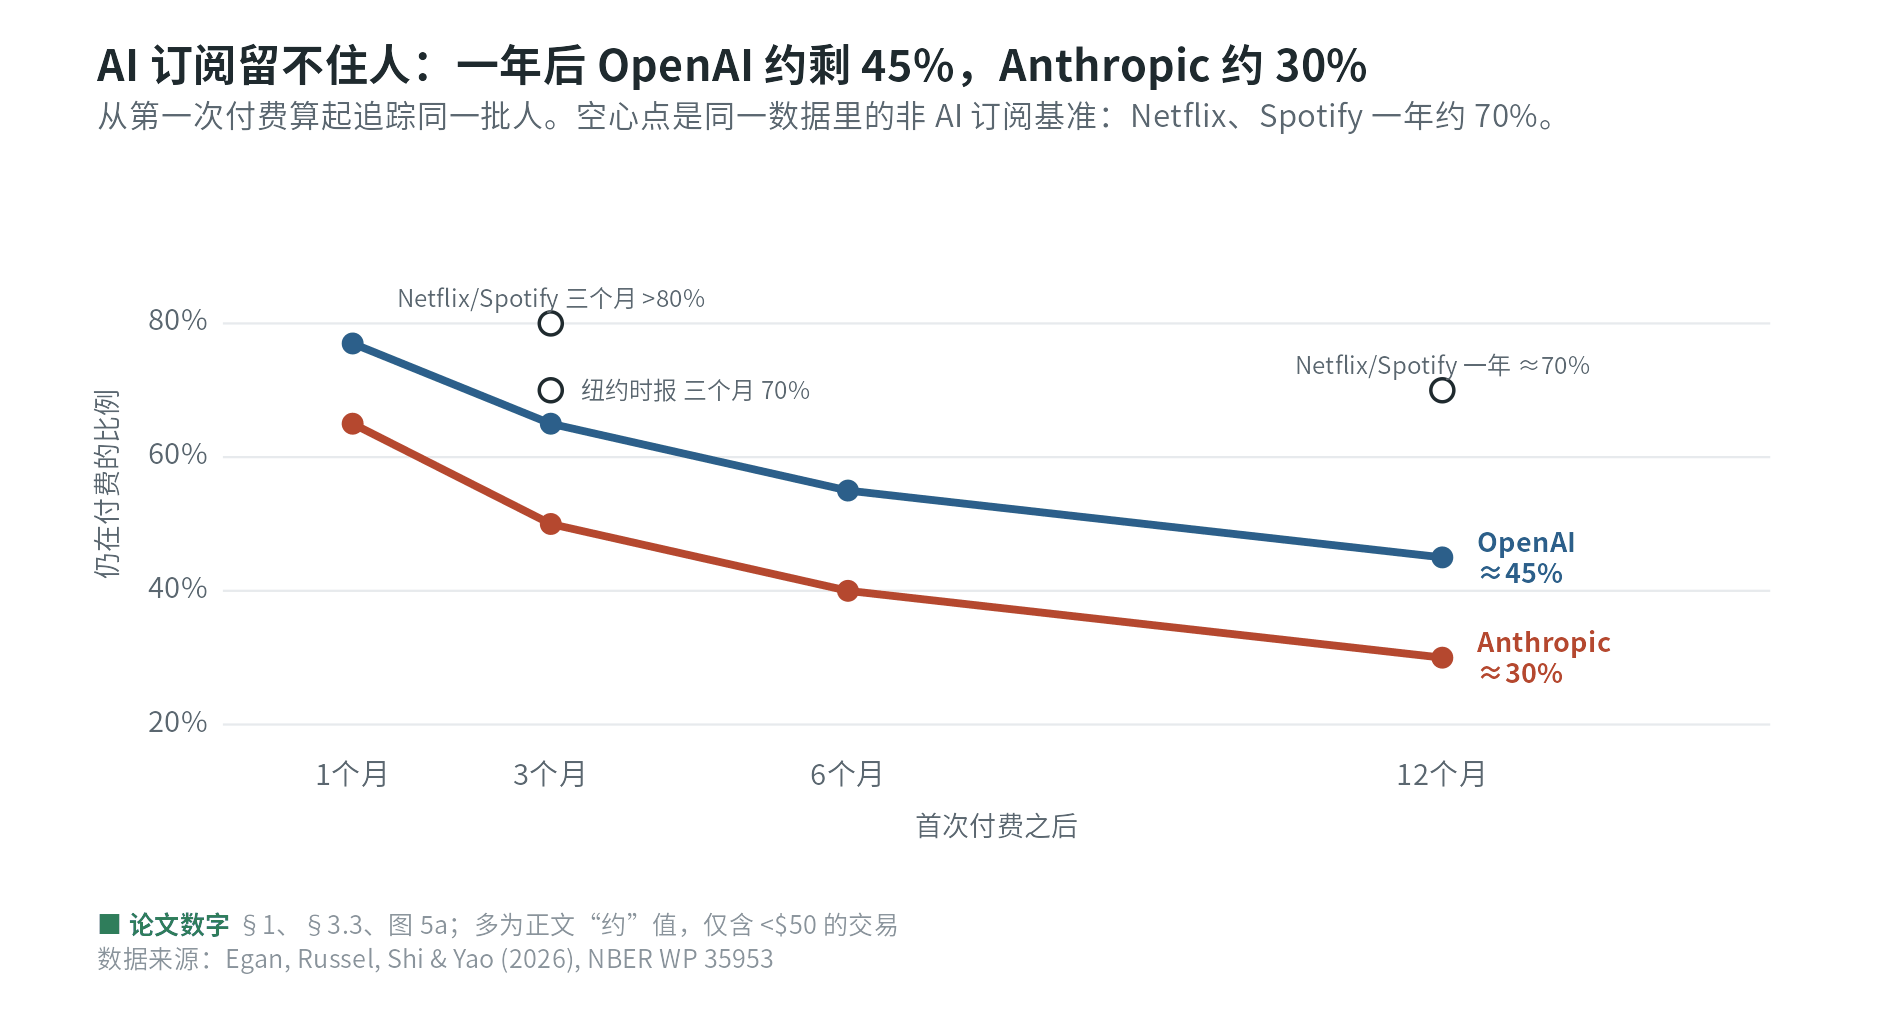
论文数字 图 2 首次付费后的留存。实心点为论文正文给出的数值(多为“约”值);空心点是同一数据中的非 AI 订阅基准。为排除季付、年付,只用单笔低于 50 美元的交易。来源:论文第 1、3.3 节与图 5 注。
留存曲线与右删失:第 12 个月的点是谁算出来的?
本科大白话2026 年 1 月才第一次付费的人,到 4 月底只能看到 3 个多月,根本不知道他第 12 个月会不会续费。这类“还没看到结局”的观测叫右删失。
论文的处理是:算第 \(M\) 个月的留存时,只用至少已被观察 \(M\) 个月的各批新用户。于是,第 1 个月的点几乎用上了所有人,第 12 个月的点只来自大约 2025 年春季以前就开始付费的早期用户。好处是不会把“还没到期”误当“流失”;代价是曲线上不同的点来自不同人群。若早期用户更铁杆,曲线尾部会被抬高。生存分析里的 Kaplan–Meier 估计也是这一思路:每一步只用当时仍“在险”的人。
异质性与动态筛选:留下来的人越来越“铁”
研究生大白话新开的健身房,第一个月走掉一大批“试试看”的人;剩下的多是真爱,以后每月走得越来越少。整体曲线先陡后平,不是因为每个人“越练越爱”,而是人群在被筛选。
如果每月留存率恒为第一个月的 77%,三个月后应剩 \(0.77^3\approx 46\%\),一年后只剩 \(0.77^{12}\approx 4\%\)。实际是 65% 和约 45%(本页换算)。按图 2 的点倒推,第 6 到第 12 个月平均每月留存约 \((45/55)^{1/6}\approx 97\%\)。隐含的月流失率(风险率)随时间大幅下降。
这正是混合分布的典型现象:若人群由“铁杆”与“尝鲜”两类组成,各自风险率都不变,总体风险率也会随时间下降,因为尝鲜者先走光了(frailty / 动态选择)。从总体曲线读出“用得越久越离不开”,就混淆了个体效应和构成变化。下面的交互图可以自己调两类人的比例感受一下。论文还报告了另一种口径的“月度留存”:上个月付过费的全部用户(不论何时开始订阅)中,本月再次付费的比例。2026 年 4 月 OpenAI 为 87%、Anthropic 与 Google 78%、xAI 66%(Spotify、Netflix 接近 95%),都高于新用户曲线的首月留存,也是同一道理:老用户里铁杆更多。
⑤′ 交互模拟:两类人混在一起,留存曲线就会“变平”
假设付费者里有两类人:“铁杆”每月留存率 \(r_L\),“尝鲜”每月留存率 \(r_C\),铁杆占比 \(q\)。总体 \(t\) 月留存 \(S(t)=q\,r_L^{\,t}+(1-q)\,r_C^{\,t}\)。虚线是“人人一样、每月都按首月留存率流失”的对照。黑点是论文 OpenAI 的四个约值。默认参数由编者粗略拟合,只作示意。
⑥ 新模型一发布,用户就流动
论文先画了一个比例的月度走势:上个月只付费 Claude 的人里,这个月开始付费 ChatGPT 的比例。GPT-4o、o1 发布前后,这个比例明显跳升;ChatGPT 加入图像生成、GPT-5 和 Codex Desktop 发布前后,也有较小的上升。
作者再把这个观察做成回归。样本只有 OpenAI、Anthropic 两家,每家每月一个观测,共 54 个“厂商×月”。因变量是切换率:上个月只订对手的人里,本月转来或加订本家的比例(单位为百分点,样本均值 2.78%)。解释变量是三个“新模型”哑变量,都针对本家:
- \(D_{jt}\):本月(第 \(t\) 月)是否发布了新模型;
- \(D_{j,t-1}\):上个月是否发布;
- \(D_{j,t-2}\):两个月前(上上个月)是否发布。
“发布新模型”有明确门槛:这家厂商的新模型把自家在能力指数(Epoch Capabilities Index,简称 ECI)上的最高分刷新了,取 1,否则取 0。以 1 月为例,三个哑变量分别看 1 月、上一年 12 月、上一年 11 月有没有这样的发布。
论文先把三个哑变量各自单独放进回归(每次只放一个),再把三个同时放进一个回归,也就是上式。同时放时,每个系数都是在另外两个月的发布情况相同的前提下,这一个月的发布带来的变化:\(\beta_0\) 是“本月发布”的效应,\(\beta_1\) 是“上月发布、到本月还剩多少效应”,\(\beta_2\) 是“上上月发布、到本月还剩多少”。三个同时放的结果:\(\hat\beta_0=0.69\)(标准误 0.28)、\(\hat\beta_1=0.63\)(0.29)、\(\hat\beta_2=0.15\)(0.21)。即新模型发布的当月和次月,切换率分别高出 0.69 和 0.63 个百分点,相对均值约 +25% 和 +23%;到第三个月不再显著。
论文还换了一种量法:不看“有没有发布”,而看本月与上月这两个月里本家 ECI 分数一共提升了多少。系数为 0.095(10% 水平显著),即 ECI 分数每多提升 1 分,切换率约高 0.095 个百分点:升级越大,流动越多。
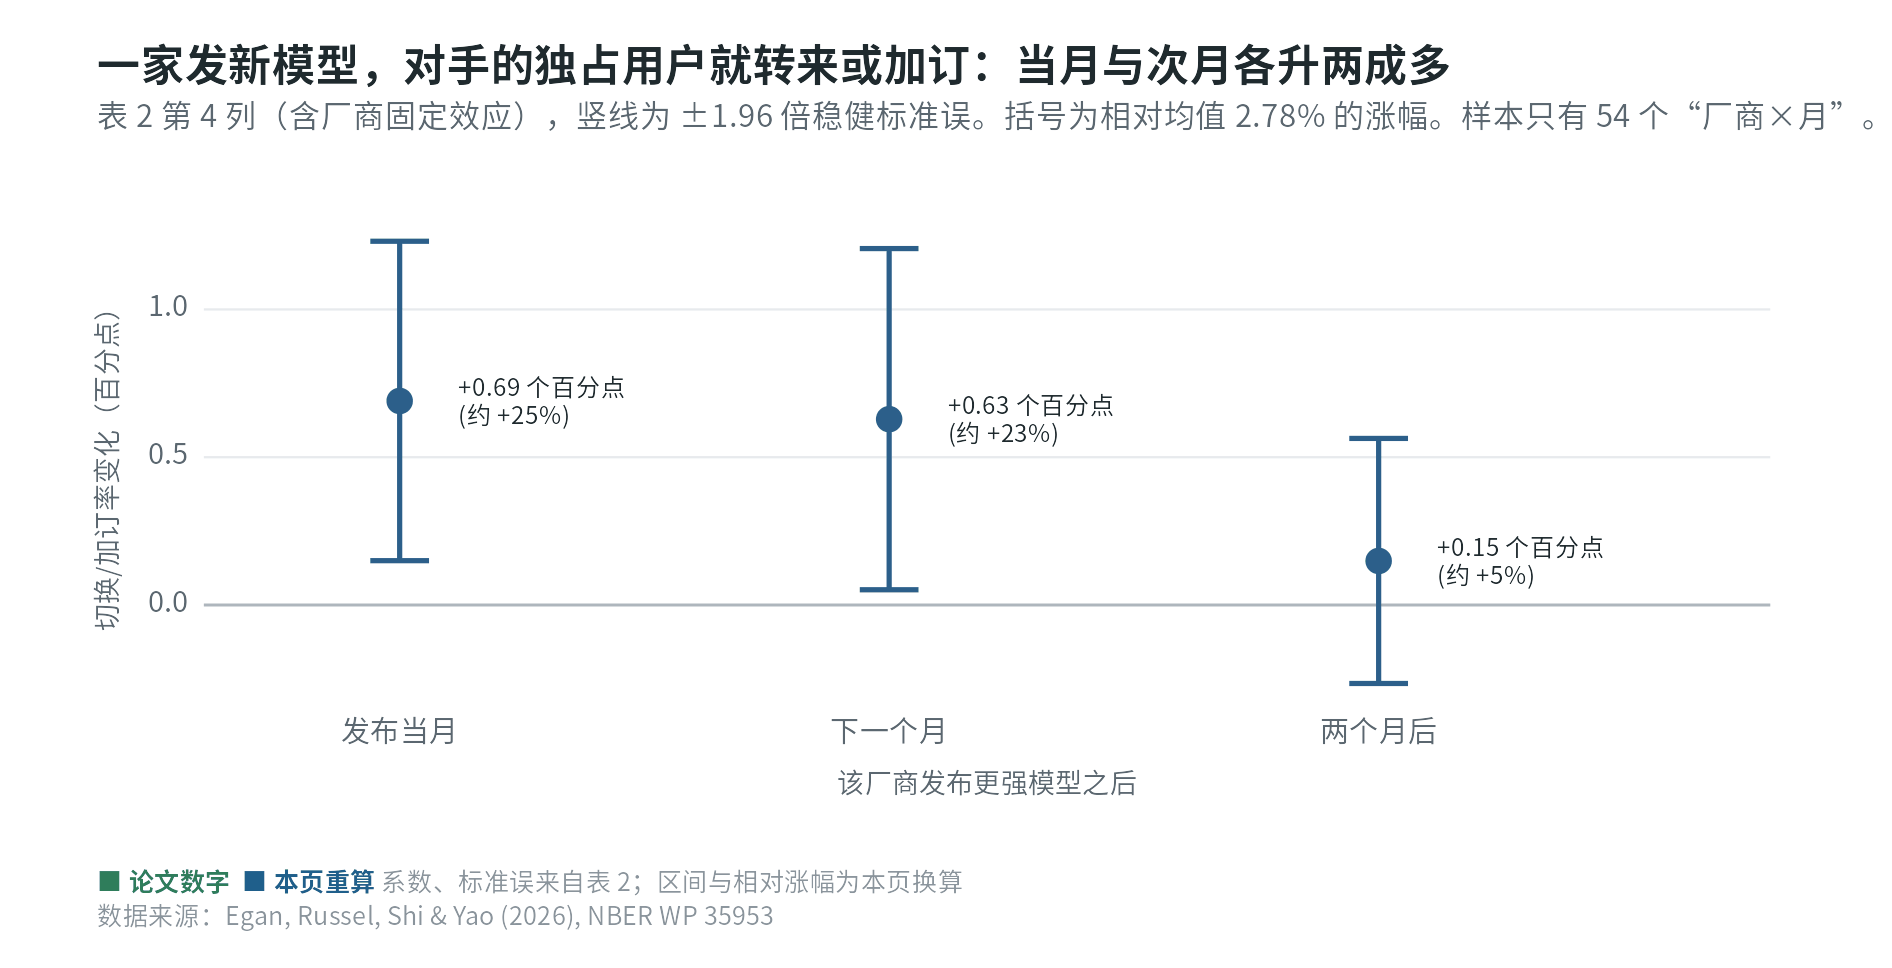
论文数字本页换算 图 3 三个哑变量同时放入时的系数(论文表 2 第 4 列)。点与标准误来自论文;95% 区间(±1.96 倍标准误)和相对均值的涨幅为编者换算。
分布滞后、固定效应与小样本推断
本科大白话新模型的效应可能拖几个月。把当月、上月、前两月的发布哑变量一起放进回归,就能看到效应“什么时候来、什么时候走”。厂商固定效应 \(\mu_j\) 则把“OpenAI 本来就更吸引人”这种常年差别先扣掉。
三个值得注意的地方。①一起放 vs 单独放:只放“上月发布”一个哑变量时,系数 0.41、不显著;三个同时放,同一个系数变成 0.63、显著。编者的解读是:各月是否发布彼此相关,只放一个月时,相邻月份的效应被混进误差项,估计就会偏;同时放才能把各月的效应分开。论文本身没有解释这一变化。②样本很小:54 个观测,95% 区间宽,当月效应的区间约为 [0.15, 1.23](本页换算),“+25%”只是点估计。③标准误口径:论文报告的是异方差稳健标准误;同一厂商相邻月份的误差可能相关,而只有两个厂商时按厂商聚类又不可行。这类“少数单位 × 多期”的面板,推断要格外谨慎。
⑦ 选择模型:订哪一家,还是订一个“组合”?
描述性事实之后,作者搭了一个结构模型,借用 Gentzkow(2007)研究“纸质报纸与网络版是互补还是替代”的框架。每个季度,消费者在 11 个选项里挑一个:什么都不订、四家里订一家、或者两两组合订两家(作者限定最多订两家;样本里订过三家及以上的不到 0.05%)。组合 \(c\) 给消费者 \(i\) 的效用是
\(\delta_{jt}\) 是大家共同认可的平均价值(价格、模型能力、其他质量),\(\theta_{ij}\) 是这个人对这家的个人偏好(长期不变),\(\Gamma_{ct}+\gamma_{ic}\) 是“两家一起订”额外多出或少掉的价值:正为互补,负为替代。\(\nu\) 是每期的随机冲击。
多项 Logit、IIA 与“对数和”消费者剩余
研究生大白话每个选项的“吸引力”取指数,再按比例分配选择概率,这就是 Logit。它的好处是概率有封闭式,消费者剩余也有现成公式。
若 \(\nu\) 独立同分布于 I 型极值分布(Gumbel),给定个人偏好 \((\theta_i,\gamma_i)\),选择概率是
IIA(无关选项独立性):在单个人身上,任意两个选项的概率之比与第三个选项无关,这在替代模式上很僵硬。模型让 \(\theta_i\) 因人而异、彼此相关,对 \(\theta\) 积分后总体份额不再满足 IIA,这就是“随机系数 Logit”的意义。
两个好用的副产品。①虽然选的是组合,但对单家产品的价格导数仍是 \(\partial s_{ij}/\partial p_j=-\alpha\, s_{ij}(1-s_{ij})\),与普通 Logit 同形。②期望最大效用有“对数和”形式,除以价格系数就换成美元:
\(K\) 是欧拉常数。拿掉某家后再算一次,两者之差就是这家给消费者带来的剩余。
相关偏好 vs 互补:用面板数据拆开,再用模拟极大似然估
研究生大白话很多人同时订 ChatGPT 和 Claude,有两种解释:一是两者搭配更好用(互补);二是这些人就是“AI 重度用户”,对哪家都爱(相关偏好),哪怕两家其实可以互相替代。横截面一张快照分不清,追踪同一个人多期才分得清。
识别逻辑:若两家互补,同一个人应倾向“要订一起订、要停一起停”;若是相关偏好,重度用户会一直在 AI 上花钱,但会随模型强弱在“订一家”和“订两家”之间来回切换,正如第 ⑥ 节看到的。关键假设是:个人偏好 \(\theta_i\) 跨期不变,每期变化只来自 \(\nu\)。
估计结果:ChatGPT 与 Claude 的偏好相关系数高达 0.889;OpenAI 与 Anthropic 的组合项 \(\Gamma\) 从 2024Q2 的 −4.10 变为 2026Q1 的 −6.44,一直是替代且越来越强。OpenAI 与 Google、与 xAI 在 2024 年还是正值(1.49、3.22),到 2026Q1 降到 −0.905 和 −0.043。所以,高多归属主要来自相关偏好,而不是互补。论文还给出:固定偏好、只看组合项的变化,Claude 用户同时订 ChatGPT 的概率在样本期内降了 83%。
怎么估:每个人的似然要对看不见的 \(\theta_i,\gamma_i\) 积分,没有封闭式。作者用 100 个打乱的 Halton 准随机点(10 维)做数值积分,即模拟极大似然;共 96 个参数,先用拉丁超立方生成 1,000 个起点,挑最好的 5 个再用 L-BFGS-B 精细优化。看估计结果时也要留意:Google 与 xAI 的偏好相关系数 0.999 已贴着边界;部分早期组合项的标准误远大于估计值本身,如 2024Q2 的 Anthropic×Google 估计为 −9.13、标准误 31.4,Anthropic×xAI 估计为 −12.9、标准误 140,正负都在误差范围内,说明这些参数几乎没被数据钉住。
⑧ 价格有多敏感?AI 值多少钱?
极大似然先估出每家每季度的平均效用 \(\delta_{jt}\):2026Q1 时 OpenAI −12.1、Anthropic −14.3、Google −16.2、xAI −17.0(以“不订”为 0,负值说明大多数人不订)。第二步把 \(\delta_{jt}\) 对价格和模型能力回归,拆出价格系数 \(\alpha\)。
价格内生性与工具变量:只有一次涨价可用
研究生大白话厂商定价时看得见自家产品好不好;产品好的往往敢定高价。直接把“价格”和“受欢迎程度”做回归,高价产品看起来“没那么吓跑人”,价格敏感度就被低估了。
回归式是 \(\hat\delta_{jt}=-\alpha p_{jt}+X_{jt}'\beta+\xi_{jt}\)。若未观测质量 \(\xi\) 与价格相关,OLS 有偏。作者的工具变量是一个哑变量:xAI 在 2025 年第一季度及以后取 1,对应 xAI 入门订阅从 16 美元涨到 30 美元之后。因为 OpenAI、Anthropic、Google 在样本期内都没调价,厂商内部唯一的价格变动就来自 xAI。
结果:OLS 价格系数 −0.179(0.049),IV 为 −0.222(0.039)。IV 绝对值更大,与“OLS 低估价格敏感度”的直觉一致。但要清楚它的分量:整个价格效应几乎全靠一家公司的一次涨价识别;排他性要求那次涨价前后 xAI 的未观测质量没有同步跳变,而论文在脚注中提到,Grok 3 恰在同期发布。模型能力已放进 \(X\) 控制,这一点仍值得打个问号。
支付意愿:效用差 ÷ 价格系数
本科大白话效用本身没有单位。价格系数告诉你“1 美元值多少效用”,用它一除,效用差就变成了美元,好比把“分”换算成“元”。
单位是美元/月,这就是正文“平均消费者每月愿为 OpenAI 比 Anthropic 多付约 10 美元”(本页换算复核)。同理,OpenAI 偏好的标准差 6.00 换成美元,上、下四分位相差 \(1.349\times6.00/0.222\approx36.5\)(正态分布的上、下四分位相距 1.349 个标准差),对应正文的 37 美元;从 GPT-4 到 GPT-5.5 的能力提升约值每月 25 美元。IV 估计还对应平均自价格弹性 −4.6:涨价 1%,需求约降 4.6%。
注意口径:这些美元数只针对“付费订阅”这一选择。论文提到另一项研究用问卷问“放弃 AI 一个月要补偿多少”,均值约 124.5 美元、中位数约 11.4 美元,量的是包括免费使用在内的全部价值,与本文不可直接比较。
⑨ 福利与加价:AI 的好处给了谁?厂商赚多少?
用“对数和”公式算消费者剩余:付费 AI 带来的剩余从 2024 年初的每人每季度 0.20 美元,涨到 2026Q1 的 1.09 美元,增长五倍以上,其中 74% 归功于 OpenAI,Anthropic 为 0.13 美元。这个平均数很小,是因为绝大多数人根本不付费;除以付费比例后,每位 AI 付费者每季度多得约 35 美元(OpenAI 26 美元、Anthropic 4 美元)。分布极不均匀:OpenAI 偏好最强的 10% 消费者拿走了 97% 以上的剩余。
供给侧,作者假设各家静态 Bertrand 定价,由一阶条件倒推边际成本。静态加价:OpenAI 每月 11.8 美元(勒纳指数 59.0%)、Anthropic 8.62 美元(43.1%)、Google 7.45 美元(37.3%)、xAI 5.77 美元(19.2%)。若加入“用户越多、模型进步越快”的动态激励,加价更低,OpenAI 降到 4.07 美元(20.3%);动态版本下边际成本约占收入的 70%–80%。
勒纳指数与“谁的弹性”:平均 −4.6,为什么还能加价 59%?
研究生大白话菜市场里多数路人对价格很敏感,但真正掏钱的熟客不太在乎。商家定价看的是“会买的人”有多敏感,而不是路人。
单产品厂商的一阶条件可写成:勒纳指数等于“按购买概率加权的弹性”的倒数:
由上面的静态加价,OpenAI 的勒纳指数 59%,倒推 \(|\bar\varepsilon|\approx1/0.59\approx1.7\)(本页换算),比正文的平均弹性 −4.6 小得多。两者不矛盾:在 Logit 里个人弹性约为 \(-\alpha p(1-s_{ij})\),越喜欢 OpenAI 的人 \(s_{ij}\) 越大、弹性越小,而加权恰好给他们最大的权重。偏好异质性越强,“平均弹性”与“定价用的弹性”差得越远。论文没有细说 −4.6 的加权口径,这里只作机制说明。
⑩ 反事实:如果不再互相替代?如果 Anthropic 不存在?
有了需求和成本,就能在模型里“改一处设定、让各家重新定价”。论文做了三个 2026Q1 的反事实。
替代性归零(Γ=0):各家都涨价,Anthropic 从 20 美元涨到 26.2 美元,份额却从 0.503% 升到 0.962%,接近翻倍。原因是 Anthropic 与 OpenAI 的替代性最强(Γ=−6.44),拿掉这层竞争,受益最大的就是它。改为互补(取 |Γ|):各家每月多收 6–12 美元,OpenAI 份额升 16%,Anthropic 升 364%。偏好互不相关:各家价格上调 2.1%(OpenAI)到 8.7%(xAI),Anthropic 与 xAI 的份额分别升 28.8% 和 29.8%。
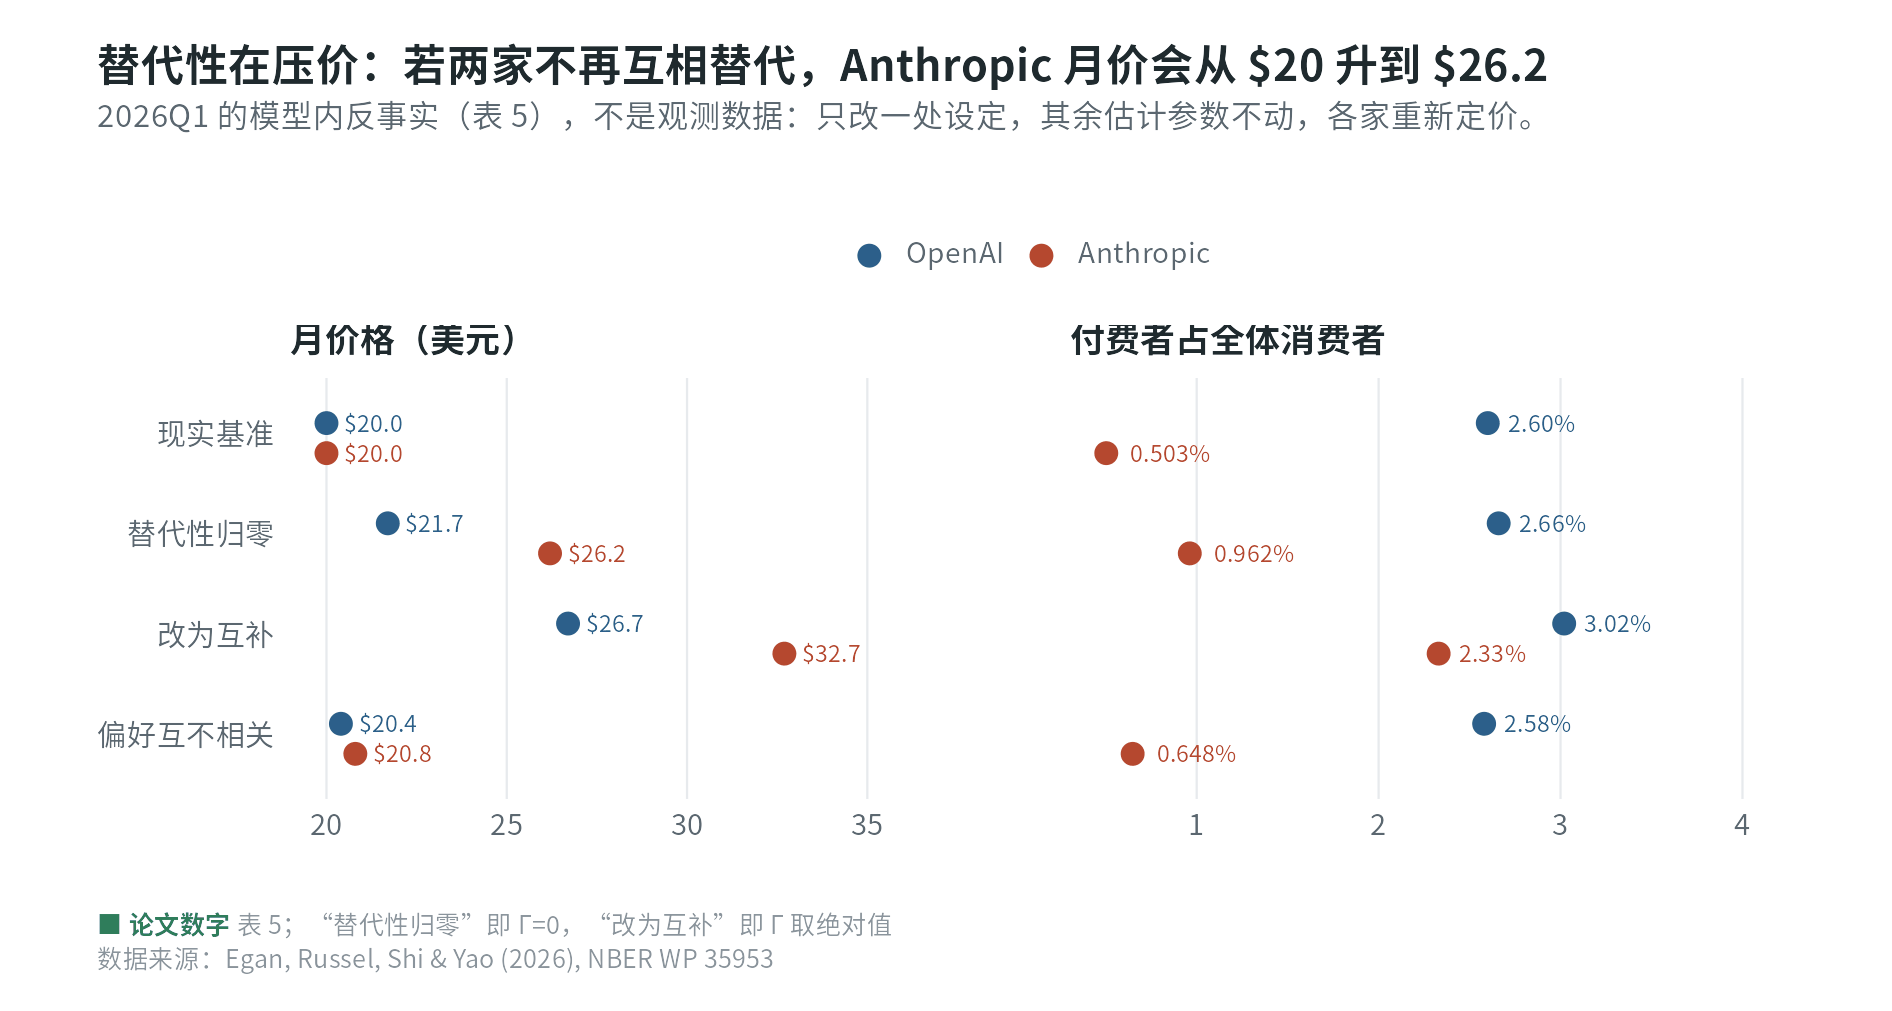
论文数字 图 4 三个反事实中 OpenAI 与 Anthropic 的价格和份额。份额是付费者占全体消费者的比例。均为模型内计算,不是观测数据。来源:论文表 5。
最有意思的是另一个反事实:把 Anthropic 从市场拿掉,其余三家重新定价。OpenAI 涨价 2.0%、xAI 涨价 1.1%,Google 反而降价 4.4%。OpenAI 的份额竟然下降 0.7%:最接近的对手没了,它顺势涨价,涨价赶走的用户比从 Anthropic 接手的还多。xAI 份额升 17.1%,Google 降 7.0%。每位 AI 用户每季度福利损失 5.05 美元,比不考虑重新定价的“局部均衡”损失大 21%。
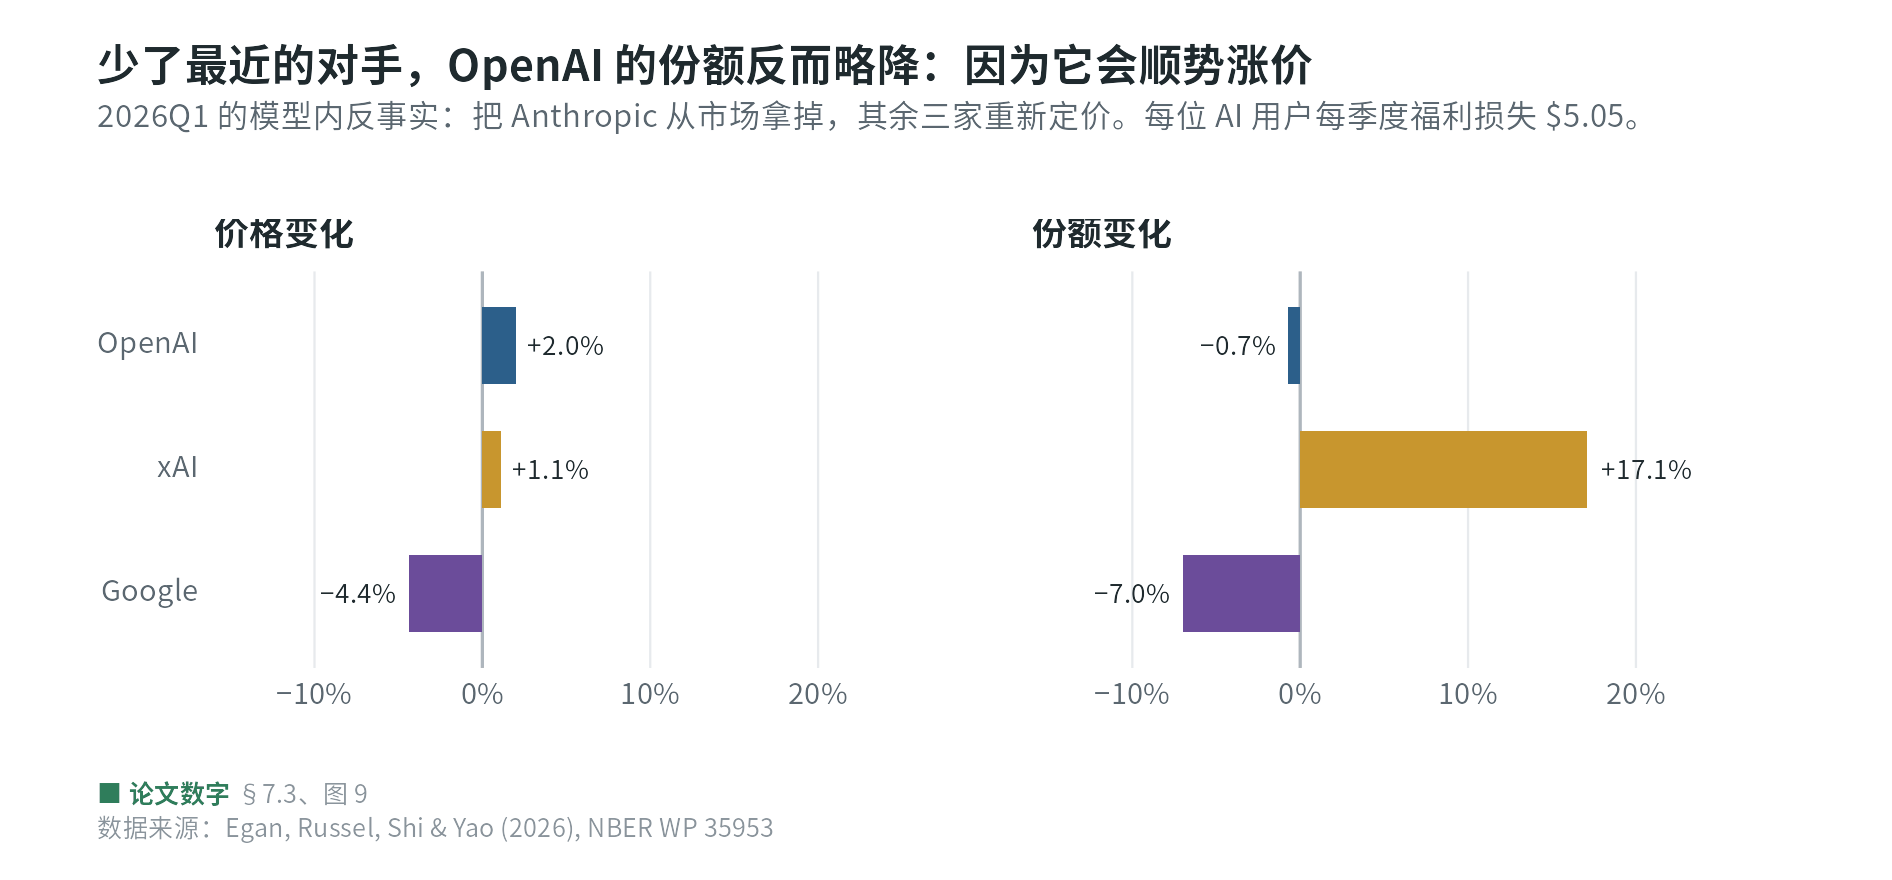
论文数字 图 5 移除 Anthropic 后其余三家的价格与份额变化(论文图 9)。
反事实模拟:是“模型里的结论”,不是观测
本科大白话天气预报说“如果明天冷空气提前到,会降温 8 度”,这是根据大气模型算的,不是谁真的看见了。反事实也是:在估好的模型里改一个开关,看各方怎么反应。
它的可信度取决于三件事。①其他参数不变:论文在反事实结果的表注中写明“所有反事实保持其他参数固定”;现实中若 Anthropic 消失,用户偏好、其他厂商的产品策略都可能变。②模型设定:最多订两家、静态 Bertrand 定价、偏好服从正态,任何一条改了,数字都会动。③被估参数的精度:第 ⑧ 节的价格系数靠一次涨价识别,所有美元换算都要除以它,误差会一路传下去。这些反事实都没有给出置信区间,读的时候把它当成“方向与量级”的推断更稳妥。
对投资者而言,这一节的含义很直接:份额小的竞争者也可能有很大的定价约束力。判断一家 AI 公司的定价权,不能只看市场份额,还要看它与对手有多可替代、用户的偏好有多相关。
⑪ 局限与读法
- 只看见刷卡付费的个人。免费用户、企业账户、可能经其他渠道付费的人都不在数据里。Google 的 AI 订阅常与 Google One 捆绑,识别规则更复杂,其数字的误差可能更大。
- 专有数据,无法复现。能核对的只有正文与表格;作者中有人与数据提供方存在顾问关系,论文已披露。
- 价格效应识别薄。只有 xAI 一次涨价提供厂商内部的价格变动,而同期还有新模型发布。
- 模型的简化。最多订两家、偏好不随时间变;按季度看“是否订过”会把月内的切换抹平。
- 市场变化极快。样本截至 2026 年 4 月;新模型、新定价档位(如更贵的高级订阅)都会改变替代格局。
- 工作论文。尚未经同行评审。
这篇论文的统计价值在于展示了一条完整链条:先用描述统计把事实立住(覆盖、优势比、留存、事件回归),再用结构模型把“为什么”和“如果”算出来。读者可以分别检查每一环的假设。
⑫ 思考题
Q1(优势比 · 本科)某月 1,000 人中:都订 4 人,只订 OpenAI 20 人,只订 Anthropic 6 人,都不订 970 人。多归属指数是多少?若两家独立,“都订”大约应有几人?
提示:优势比 \(=4\times970/(20\times6)\approx32.3\),对数约 3.5。独立时 \(P(\text{都订})\approx p_Op_A=0.024\times0.010\),约 0.24 人。数字为编者虚构,仅供练习。
Q2(覆盖偏差 · 本科)若年轻人更常通过手机应用商店付费(商户名显示为应用商店而非 AI 公司),论文的“年轻人付费率更高”会被高估还是低估?
提示:若年轻人的付费更多被漏记,则年轻人付费率被低估,年龄差距反而被低估。这是思考题假设,论文未讨论此渠道的规模。
Q3(动态选择 · 研究生)人群中 40% 为“铁杆”(月留存 97%)、60% 为“尝鲜”(月留存 50%)。一个月后、一年后的总体留存各是多少?总体月风险率是否随时间下降?
提示:一个月 \(0.4\times0.97+0.6\times0.5=68.8\%\);一年 \(0.4\times0.97^{12}+0.6\times0.5^{12}\approx27.8\%\)。每类的风险率不变,总体风险率却从约 31% 降到接近 3%。可用上面的交互图验证。
Q4(分布滞后 · 本科)切换率回归中,只放“上月发布”哑变量时系数 0.41(不显著),把本月、上月、上上月三个哑变量同时放入时变成 0.63(显著)。请用遗漏变量偏误解释。
提示:若当月与上月的发布哑变量负相关(发布不会连续两个月都有),只放上月时,当月效应被留在误差项里,与上月哑变量负相关,使上月系数被拉低。
Q5(工具变量 · 研究生)为什么 OLS 价格系数(−0.179)的绝对值小于 IV(−0.222)?若 xAI 涨价同期其未观测质量上升,IV 估计会偏向哪边?
提示:未观测质量与价格正相关,使 OLS 偏向 0。若工具与 \(\xi\) 正相关,IV 同样会被拉向 0(低估敏感度),真实 \(\alpha\) 可能更大。
Q6(支付意愿 · 本科)若价格系数是 −0.179(OLS)而不是 −0.222,OpenAI 相对 Anthropic 的支付意愿会是多少?
提示:\(2.2/0.179\approx12.3\) 美元/月。价格系数越小,同样的效用差折算成越多美元,可见所有美元结论对 \(\alpha\) 都很敏感。
Q7(研究设计 · 研究生)国内几家大模型应用同时提供免费和会员版。若你拿到某支付平台的会员扣费数据,想复制本文的“多归属指数”和“留存曲线”,需要先处理哪些问题?
提示:会员档位与连续包月识别、免费使用不可见、多账号与家庭共享、试用期首月低价造成的“假留存”、样本覆盖(只看该支付渠道)、以及右删失的处理。
知识点索引
本科 7 个,研究生 5 个。
资料来源与核实说明:数字摘自 Egan、Russel、Shi 与 Yao(2026)NBER 工作论文 35953 的摘要、§1–§8、表 1–5、图 4–9 注释与附录 A.1、B.1、C.1。图 1、2、4、5 只画论文数字(图 2 多为正文“约”值);图 3 的 95% 区间与相对涨幅、知识点 5 的恒定留存推算、知识点 10 的支付意愿复核、知识点 11 的加权弹性倒推,均为编者换算,标 本页换算;交互图为两类人群的模拟,标 示意。思考题中的虚构数字仅供练习。正文对“偏好互不相关”情形下 OpenAI 涨价幅度写作 2.1%,表 5 价格为 20.0→20.4 美元(约 2.0%),差异来自四舍五入,本页按正文。
与前几期的区别:第 4 期讲预测市场校准,第 5 期讲断点回归,第 6 期讲成本转嫁与双重差分。本期主线是平台竞争的需求估计:从优势比、留存与删失这些描述工具,到离散选择、模拟极大似然、工具变量与反事实,第一次系统讲“结构模型”这条线。